Hur vet du att din agent fungerar? — Evals i praktiken
Det finns inget standardsätt att testa AI-agenter. Tre kundprojekt, tre olika utmaningar och tre olika lösningar: deterministiskt facit, konsensusbyggt facit, och inget facit alls.
Nyckelinsikter
- LLM-benchmarks mäter modellens förmåga. Evals mäter hela agentlösningens förmåga i en specifik domän.
- Den största utmaningen med evals är att skapa facit, inte att skriva testscript: i många domäner finns inget entydigt rätt svar.
- Blindtest, där agenten får riktig kunddata och output jämförs mot expertens faktiska beslut, avslöjar systematiska antagandeskillnader som ingen prompt-iteration hittar.
- Eval-avvikelser berättar oftare något om domänen än om agenten: de tvingar fram diskussioner om vad 'rätt' egentligen innebär.
- Tre eval-strategier fungerar i praktiken: deterministisk jämförelse (facit finns), konsensusbaserat facit (experter skapar sanning), och A/B-varianter (output är naturligt språk).
Sammanfattning
LLM-benchmarks som MMLU, HumanEval och SWE-bench mäter modellens generella förmåga. Men när du bygger en agent som ska generera XML-filer för industriella värmekablar, kontrollera leverantörsfakturor mot orderdatabaser, eller dimensionera produktionslinjer hjälper inga benchmarks. Du behöver evals: domänspecifik validering av hela agentlösningen, från input till output.
Jag har byggt evals i tre kundprojekt det senaste halvåret. Varje projekt hade olika förutsättningar och krävde olika lösningar. Den här artikeln delar vad jag lärde mig.
Varför evals är svårare än det låter
Det intuitiva angreppssättet, "kör agenten, kolla om svaret är rätt", kollapsar snabbt i praktiken. Tre problem dyker upp omedelbart:
Facit-problemet. I många domäner finns inget entydigt rätt svar. Tre experter ger tre olika svar, alla giltiga. Vad ska agenten jämföras mot?
Tolerans-problemet. Även när facit finns: hur mycket får agenten avvika? 5% i en termisk beräkning? En annan kabeltyp som också fungerar? En annan formulering av samma slutsats?
Input-problemet. Om agenten ger ett annat svar, beror det på att beräkningsmodellen är fel, eller på att agenten tolkade kunddata annorlunda? Eval måste kunna skilja dessa fall.
Tre projekt, tre verkligheter
Projekt 1: Deterministiskt facit finns
En agent för industriella värmekablar som tar emot kundförfrågningar via mejl och producerar beräkningar, kabelrekommendationer och projektfiler (.edp20) för ett branschverktyg.
Vi hade tur: det befintliga beräkningsprogrammet (Elterm Designer) ger deterministiska resultat. Teknikernas faktiska projektfiler kunde extraheras och bli maskinläsbart facit.
Eval-resan i tre faser:
Fas 1: manuell grading. Sju kundcase extraherade ur en teknikers mejlarkiv. Varje case kördes genom agenten, output bedömdes manuellt på en 1–5-skala över sju dimensioner (frågor, produktfamilj, specifik produkt, EX-klassning, temperatur, tillbehör, varningar). Resultat: 230/245 poäng (94%) med skill, ~25% utan. Tillräckligt för att visa kunden att agenten skapar värde, men inte för att iterera på detaljer.
Fas 2: semi-automatiserad grading. Ett script som extraherar parametrar ur agentens markdown-output och jämför numeriskt mot facit, med definierade toleranser per fält (temperatur ±0.1°C, diameter ±0.01 mm). Tre bedömningsnivåer: parameterinsamling (D1), beräkningsresultat och kabelrekommendation (D2A), och projektfilskonfiguration (D2B).
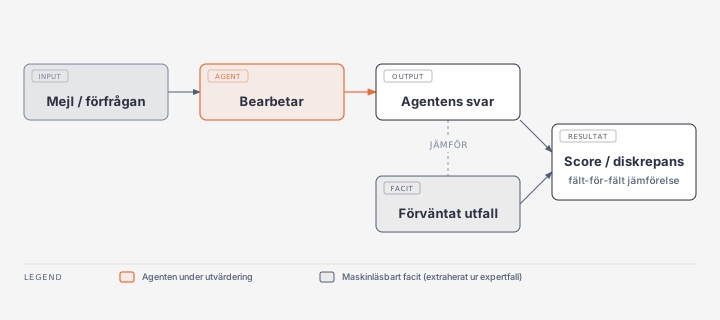
Fas 3: helautomatiserad blindtest. En eval-pipeline (run_eval.py) som kör hela kedjan programmatiskt (termisk beräkning, kabelfiltrering, projektfilsgenerering) mot fem referenscase med maskinläsbara facit-filer. Varje case består av:
mailtrad.mdför den ursprungliga kundkommunikationen (agentens input)facit-extracted.jsonmed alla parametrar från teknikerns faktiska projektfacit.edp20, teknikerns projektfil (komplett referens)
Agenten får mejltråden. Producerar output. Output jämförs fält-för-fält mot facit.
Vad blindtesterna avslöjade:
Det mest värdefulla var de systematiska skillnaderna mellan agentens och teknikernas beslut, inte buggarna. Tio dokumenterade fall av vad jag kallar antagandedivergens:
- Installationstemperatur: Agenten satte den lika med omgivningstemperaturen (−20°C). Teknikerna sätter alltid 5°C, en branschkonvention som inte finns i någon specifikation.
- Mantelval: Agenten valde konsekvent BOT (dyrare, kemiskt resistent) "för säkerhets skull". Teknikerna väljer AO (billigare) när kemisk resistens inte krävs — kostnadsoptimering som agenten saknade vikt för.
- Processtemperatur: En kund behövde 280°C, men ingen kabel klarar det. Agenten: 0 kandidater, stopp. Teknikern: satte 250°C (kabelns gräns) och flaggade risken i ett separat mejl. Pragmatism som agenten inte hade.
- Dimensionsavrundning: Teknikern rundar upp till närmaste standard-DN. Agenten använder kundens exakta mått. Båda kan vara rätt, men det ger 13% avvikelse i eval om man inte förstår varför.
Varje antagandedivergens blev en diskussion med domänexperten, inte om att "agenten har fel" utan om vad som ska vara rätt.
Projekt 2: Inget facit existerar
En agent för produktionsdimensionering som översätter kunders operationslistor till ett maskinföretags nomenklatur, validerar tidsdata och föreslår linjebalansering.
Här var förutsättningarna helt annorlunda. Tre produktionstekniker hade var sin metod: en aggressivt GSD-driven, en erfarenhetsbaserad och försiktig, en kundanpassad. De var inte ens överens om vad "standardcase" innebar. VD:n sa rakt ut: "Det är inte så att vi har en välfungerande process som vi vill automatisera."
Eval-strategi: Skapa facit genom konsensus.
Projektet har 77 pytest (enhets- och integrationstester) som validerar agentens logik mot registrets interna data. Men det är funktionell testning, inte evals. Den verkliga valideringen sker genom intervjuer och expertgranskning.
Det avgörande beslutet kom efter fyra intervjuer: alla tre tekniker ska lösa samma kundcase individuellt, sedan diskutera i grupp, sedan landa i konsensus. Resultaten blir referenscase att evaluera agenten mot.
Ibland är eval-processen viktigare än eval-resultaten. Att tvinga organisationen att definiera "rätt svar" skapar i sig en kvalitetshöjning, oavsett vad agenten gör.
Två av teknikerna är konsulter vars jobb potentiellt ersätts av verktyget. Det påverkar deras incitament att bidra med facit. Eval-design kan inte separeras från organisationsdynamik.
Projekt 3: Output är naturligt språk
En agent som kontrollerar leverantörsfakturor mot orderdata och rapporterar VERIFIED, DISCREPANCY eller UNVERIFIABLE, med motiveringar i fritext.
Här fungerar inte numerisk jämförelse. En korrekt rapport kan formuleras på hundra sätt. Och "korrekt" har nyanser: agenten kan hitta rätt avvikelse men formulera sig otydligt, eller missa en avvikelse men producera en övertygande rapport.
Eval-strategi: A/B-varianter med fullständig trace.
Systemet lagrar agentinstruktioner (systemprompts) som namngivna varianter. Samma faktura körs med olika varianter. Varje körning sparar en fullständig trace: agentens interna resonemang, varje verktygsanrop med input/output, token-användning, tidsstämplar.
Istället för "rätt eller fel" mäts:
- Antal matchade rader vs avvikelser
- Agentens resonemangskedja (via trace)
- Kostnad per körning (USD, tokens, antal turns)
- Tid till resultat
Validering sker genom att en människa granskar rapporten och tracen i ett dedikerat UI med separata flikar för produktion och test.
När output är naturligt språk, optimera för observerbarhet snarare än automatiserad bedömning. Fullständig trace gör varje agentbeslut inspekterbart, och det räcker ofta längre än ett automatiserat eval-script som ändå inte kan bedöma om en formulering är bra.
Mönster som framträder
Trots att projekten är helt olika ser jag tre mönster:
1. Eval-mognadstrappan
Manuell grading → Semi-automatiserad → Helautomatiserad
   "Ser det rätt ut?"    "Extrahera och jämför"    "Kör pipeline mot facit"
De flesta börjar med manuell grading, och det är rätt. Det ger snabb feedback och bygger intuition för vad agenten gör bra och dåligt. Men det skalar inte. Semi-automatiserad grading (extrahera output, jämför numeriskt) är sweet spot för de flesta projekt. Helautomatiserad pipeline behövs först när du itererar på beräkningsmodeller och behöver regressionstestning.
2. Eval avslöjar domänen, inte bara agenten
I alla tre projekten var den viktigaste outputen från eval-arbetet inte "agenten har X% rätt" utan insikter om domänen:
- Tio antagandedivergensfrågor som drev kvalitetsdiskussioner med kunden
- Upptäckten att teknikerna inte har en gemensam process
- Säkerhetshål (SSRF, auth bypass) som hittades genom systematisk granskning
Eval är ett verktyg för domänförståelse. Sälj det som det.
3. Facit-frågan avgör allt
| Facit-typ | Strategi | Exempel |
|---|---|---|
| Deterministiskt facit finns | Automatiserad jämförelse med toleranser | Beräkningsprogram, API:er med kända svar |
| Expertkunskap finns men varierar | Konsensusprocess → referenscase | Erfarenhetsbaserade beslut, konfiguration |
| Inget facit möjligt | A/B-varianter + trace + mänsklig granskning | Naturligt språk, kreativa uppgifter |
Fråga dig alltid: "Finns det ett facit, och i vilken form?" Svaret bestämmer hela eval-strategin.
Verktygen jag använder
Två verktyg har varit centrala i mitt eval-arbete. De representerar två helt olika ansatser.
Skill-creators inbyggda evals (projekt 1)
Anthropics skill-creator har ett inbyggt eval-ramverk som jag använde för det första projektet. Principen är enkel:
- Du definierar testcase med prompt och förväntningar (assertions)
- Varje case körs parallellt i två varianter: med skill och utan skill (baseline)
- Resultaten graderas binärt per assertion och aggregeras till pass rate, tid och token-användning
- En webbvy (
eval-viewer) låter dig granska varje case kvalitativt - Din feedback sparas och driver nästa iteration av skillen
Det som gör systemet värdefullt är baselines. Att veta att agenten klarar 84% av fallen säger en sak. Att veta att den klarar 25% utan skillen, och att delta är +59 procentenheter, säger något helt annat. Det bevisar att skillens domänkunskap gör konkret skillnad via prompt-enrichment, inte bara att modellen är bra.
Jag byggde också ett skräddarsytt graderingsskript ovanpå detta som mätte numerisk överensstämmelse med toleranser per fält: temperatur ±0.1°C, diameter ±0.01 mm, effektberäkning ±5%. Det avslöjade kaskadfelen: en felaktig isoleringsparameter i steg 1 gav +45% avvikelse i steg 2:s effektberäkning. Utan den fältspecifika graderingen hade jag bara sett "beräkningen stämmer inte" utan att förstå var felet uppstod.
Tracing runt Claude Agent SDK (projekt 3)
För fakturakontrollprojektet behövde jag ett annat angreppssätt. Output är naturligt språk, en rapport om huruvida fakturarader matchar orderdata. Automatiserad grading fungerar inte. Istället byggde jag tracing runt query()-funktionen i Claude Agent SDK (en harness byggd i Python).
Varje meddelande från SDK:ns asynkrona iterator mappas till typade trace-entries: thinking, assistant, tool_call, tool_result, system, error. Token-användning ackumuleras per turn. Allt sparas i Postgres som både strukturerad JSON (JSONB för programmatisk åtkomst) och renderad markdown (för mänsklig läsning).
UI:t har separata flikar för produktion och test. För testning väljer du en instruktionsvariant i en dropdown, kör samma faktura, och ser tracen inline, med relativa tidsstämplar (+6.6s), expanderbara thinking-block och verktygsinput/-output.
Störst utväxling gav Claude Code för trace-analys. Jag exporterade tracefilerna som markdown och lät Claude Code analysera mönster: varför misslyckades varianten på denna faktura? Vilka verktyg anropades i fel ordning? Var slutade agenten söka för tidigt?
Analysen producerade konkreta instruktionsförbättringar. I en variant sökte agenten aldrig på WorkingSiteCode, vilket ledde till att den inte kunde matcha rader mot rätt arbetsplats. Den insikten blev en ny instruktionsvariant.
Genom den iterativa loopen (kör, fånga, lagra, granska, analysera, förbättra) gick kostnaden per faktura från ~$1.20 (34 turns, ~5 minuter) till ~$0.30 (8 turns, ~2 minuter), genom att förbättra instruktionerna baserat på trace-data utan att byta modell.
I praktiken: Att komma igång
Om du bygger en agent och vill införa evals, börja här:
1. Samla 5 riktiga case. Mejltrådar, kundförfrågningar, support-ärenden: det som agenten faktiskt kommer att möta, inte syntetiska exempel. Fem räcker för att börja.
2. Skapa facit, eller erkänn att du inte kan. Om det finns ett referenssystem, extrahera facit maskinläsbart. Om facit är tyst expertkunskap, organisera en konsensusprocess. Om inget facit är möjligt, bygg för observerbarhet.
3. Definiera dimensioner och toleranser. Vad mäter du, och hur mycket får agenten avvika? Separera hårda krav (fel kabeltyp = fel) från mjuka (avrundning uppåt vs exakt = tolkning).
4. Kör blindtest. Ge agenten input. Jämför output mot facit. Analysera avvikelserna, och fråga alltid: är det agentfel eller inputskillnad?
5. Dokumentera antagandedivergens. De fall där agenten och experten gör olika men giltiga val är de mest värdefulla. Varje sådant fall är en domänfråga att landa med stakeholders.
Den femte punkten är den som ger mest tillbaka. Evals definierar vad "fungerar" innebär, och det är en konversation som de flesta organisationer aldrig har haft.
Källor och vidare läsning
Se källorna i artikelns metadata för originalreferenser.
Källor
Relaterade artiklar
- harness-design-principer — Evals testar det som harnessen producerar; de kompletterar varandra