Artiklar
13 artiklar om AI-agenter, arkitektur och digital utveckling.
Köket där varje beslut sitter på väggen: spårbarhet när Claude bygger åt dig
När Claude bygger fort försvinner ofta förklaringen till varför koden blev som den blev. Ett arbetssätt från Anthropic, som jag gjort till en plugin, fungerar som ett välskött restaurangkök: beställning, meny och körschema på väggen, och varje ändring antecknad med vem som sa ja.
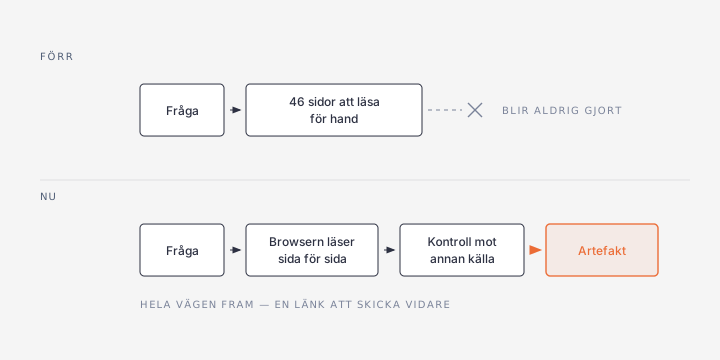
Browsern och artefakten — hur en kvällsfråga blev en delbar webbsida
Way Out West pågår och Zara Larsson spelar ikväll. Jag lät Claude öppna en webbläsare, läsa av 46 svenska artistsidor på Spotify och sedan bygga en publicerbar sida av resultatet. En kväll, ingen kod, en länk att skicka vidare.
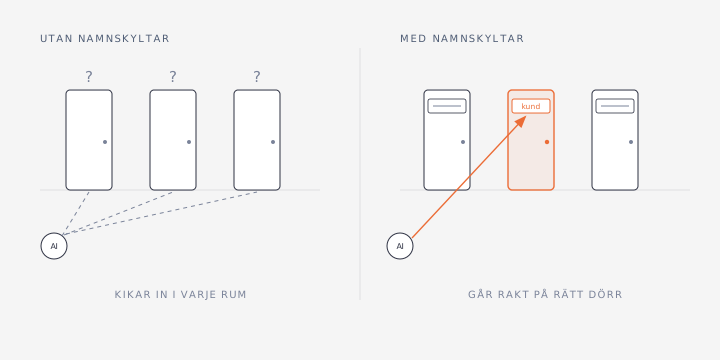
Namnskyltar för agenten — bygg en app som en AI faktiskt kan testa
Jag lät fyra browser-automationsverktyg köra samma uppgift blint mot samma app. Alla klarade den. Skillnaden i antal anrop och fel avgjordes av hur appens markup var skriven, inte av verktyget.
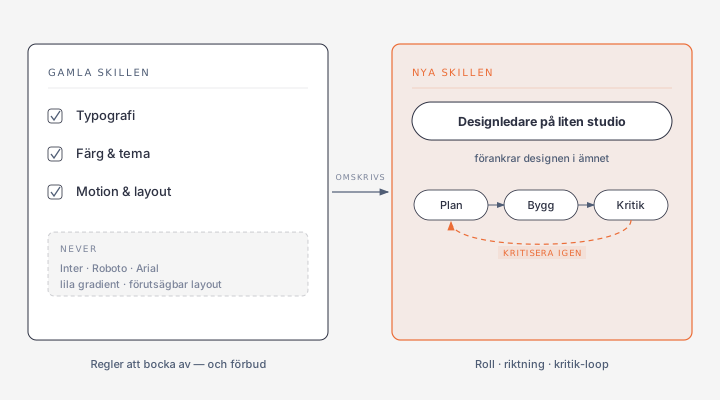
Vad en skill-diff avslöjar — Anthropics omskrivna design-skill som lektion i skill-design
Anthropic skrev nyligen om sin frontend-design skill. Att läsa diffen, vad de klippte och vad de la till, är en lektion i hur man skriver skills överhuvudtaget. Här är fyra principer jag extraherar ur deras ändringar.
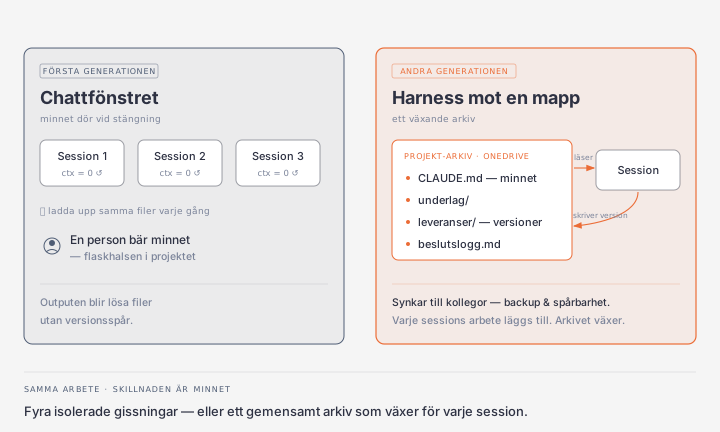
Första och andra generationens AI-stöd — från chattfönstret till det växande arkivet
Den första generationen är chattfönstret: du laddar upp filer, får ett svar, och allt försvinner när du stänger. Den andra pekar AI:n mot en mapp den läser och skriver i själv, och projektet får ett minne som växer för varje session.
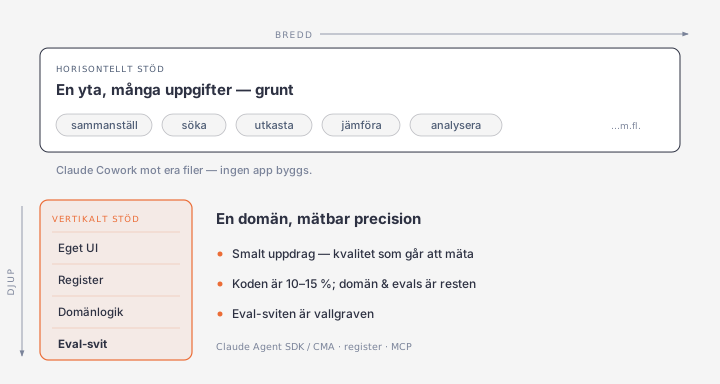
Horisontellt eller vertikalt — två sätt att ge ett företag AI-stöd
Det ena lindar en generell agent-yta runt företagets egna filer: bred täckning, ingen app byggs. Det andra bygger en skräddarsydd agent för en enda domän: smal, djup, mätbar. Mellan dem ligger ett spektrum, och valet av rätt leveransform avgör mer än valet av modell.
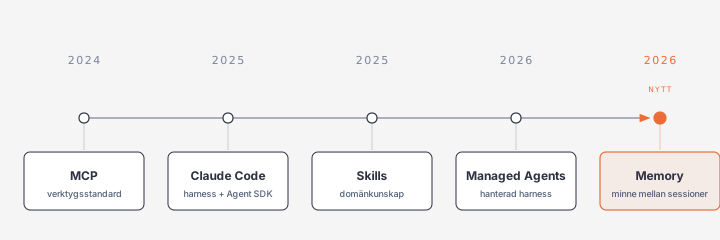
När agenter börjar drömma — Anthropics minnessystem gör context-repot till infrastruktur
Minne har varit ett gör-det-själv-mönster: CLAUDE.md och en mapp med filer. Nu produktifierar Anthropic det i Managed Agents: delade minnesstores med versionshantering, plus Dreaming, en nattlig agent som städar minnet mellan sessioner.
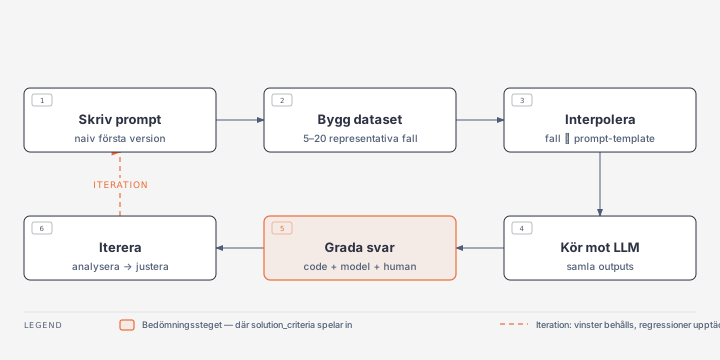
Eval-driven prompt engineering — när tweaking blir engineering
De flesta justerar prompts på gut feel. Det blir engineering först när du har ett dataset, en grader och en mätbar progression mellan iterationer. Här är fyra tekniker, en pipeline, och vad jag lärt mig om att göra det systematiskt.
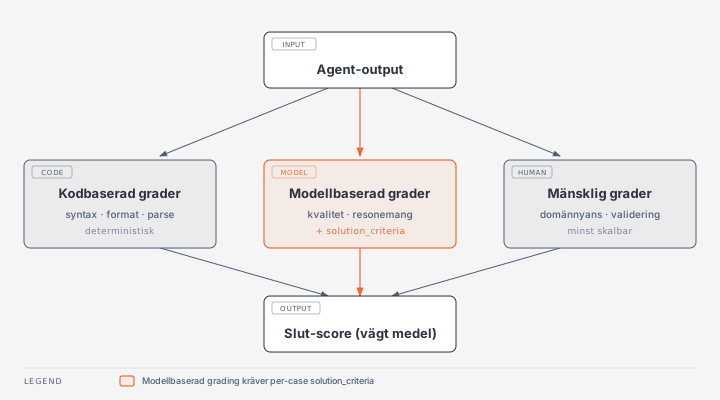
Solution criteria — det missade pusselbitet i prompt-iteration
En model grader som scorar utan ankarpunkter driftar mot 5–7. Lösningen är att flytta kriterierna in i datasetet, inte att ge gradern bättre instruktioner. Per-case solution criteria är skillnaden mellan generisk kvalitetsbedömning och meningsfull iteration.
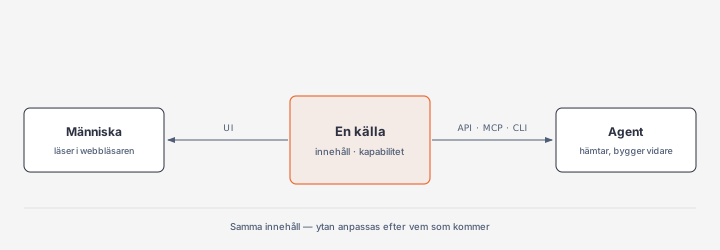
En källa, inte en destination — vad Salesforce Headless 360 säger om din egen plattform
Salesforce rev upp en 27 år gammal plattform och exponerade varje funktion som API, MCP-verktyg och CLI så att agenter kan driva systemet utan UI. Det är samma dual-use-princip som min egen sajt bygger på, fast i en helt annan storleksordning.
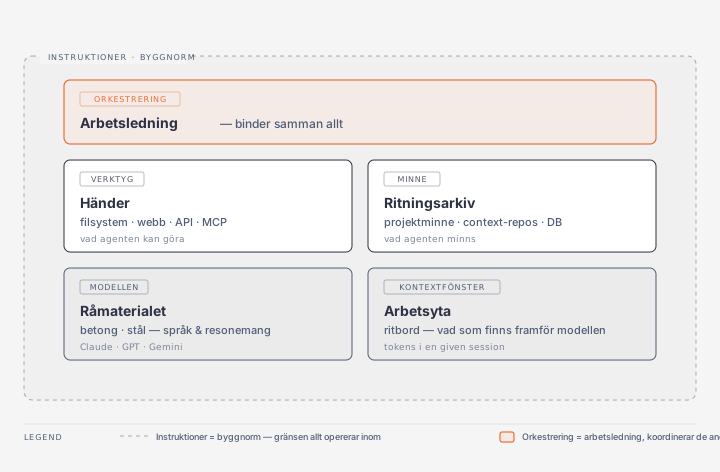
AI-agenternas byggmaterial — en konstruktionslära för beställare och arkitekter
Precis som husarkitekter behöver förstå bärande väggar, isolering och ventilation behöver den som bygger eller beställer AI-agenter förstå modeller, kontextfönster, verktyg, minne, instruktioner och orkestrering. Här är grundkursen.
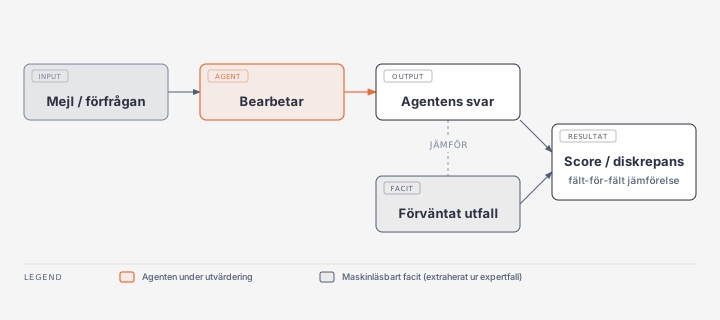
Hur vet du att din agent fungerar? — Evals i praktiken
Det finns inget standardsätt att testa AI-agenter. Tre kundprojekt, tre olika utmaningar och tre olika lösningar: deterministiskt facit, konsensusbyggt facit, och inget facit alls.
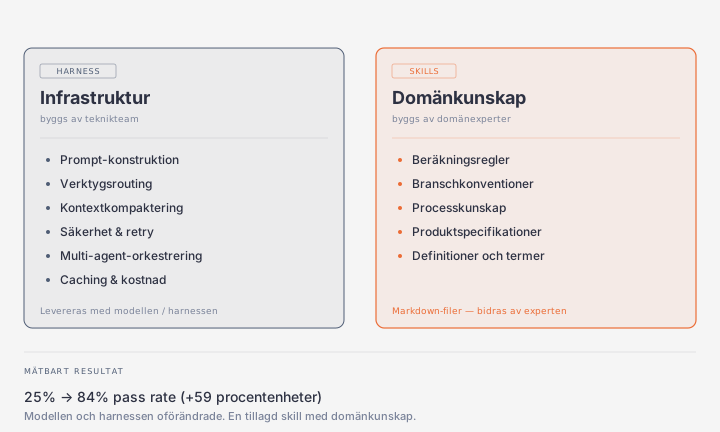
Harnessen — det osynliga lagret som avgör om din AI-agent fungerar
Lagret mellan dig och AI:n bygger kontexten, väljer verktyg, komprimerar konversationen och hanterar säkerheten. Här listar jag vad en modern harness gör, kapabilitet för kapabilitet.