Eval-driven prompt engineering — när tweaking blir engineering
De flesta justerar prompts på gut feel. Det blir engineering först när du har ett dataset, en grader och en mätbar progression mellan iterationer. Här är fyra tekniker, en pipeline, och vad jag lärt mig om att göra det systematiskt.
Nyckelinsikter
- Att 'tweaka' en prompt utan eval-pipeline är gut feel. Det blir engineering först när varje förändring kan jämföras mot ett stabilt dataset av representativa fall.
- De fyra grundteknikerna (Clear & Direct, Being Specific, XML Tags, Examples) ger var för sig mätbar förbättring, men bara om du applicerar dem mot ett dataset i stället för ett enskilt exempel.
- En naiv prompt landar ofta runt 2–3 av 10 i kvalitetsbedömning; samma uppgift med samtliga fyra tekniker applicerade når 7–8. Det är 3× lyft utan att byta modell.
- Specificitet kommer i två varianter: Type A (önskade attribut i outputen) och Type B (steg modellen ska följa när den resonerar). De har olika syften och löser olika problem.
- Examples ska placeras *efter* instruktionerna och måste inkludera *varför* de är ideala. Annars härmar modellen formen utan att förstå substansen.
Sammanfattning
Det finns två sätt att förbättra en prompt. Det första, som de flesta gör, är att tweaka den. Du kör den, något ser konstigt ut, du ändrar en formulering, kör igen, och om resultatet känns bättre behåller du ändringen. Det är gut feel. Snabbt, intuitivt och fundamentalt omätbart.
Det andra sättet är att engineera den. Du etablerar ett dataset av representativa fall, definierar hur svaren ska bedömas, och iterar mot ett objektivt mått. Förändringar i prompten valideras mot hela datasetet. Det går långsammare per iteration men varje vinst är bevisbar. Det är en eval-driven arbetsmetod. Utan den är prompt-utveckling halvblint.
Den här artikeln handlar om hur du gör det andra. Fyra grundtekniker som var för sig ger mätbar förbättring, en eval-pipeline som ryggrad, och konkreta verktyg för att hålla iterationen ärlig.
Tweak vs engineer
Skillnaden låter abstrakt men är konkret. När du tweakar en prompt baseras varje ändring på ett enskilt exempel. Du löste fallet du tittade på, men introducerade kanske regression i tre andra fall som du inte testade. Du har ingen aning. Sex iterationer senare är prompten en tjock kompromiss av ad-hoc-fixar och prompten blir paradoxalt nog sämre över tid.
När du engineerar en prompt har du:
- Ett dataset av 5–20 representativa fall: riktiga input som prompten kommer att möta
- En grader som bedömer varje output enligt definierade kriterier
- En baseline-score att jämföra mot
En ändring i prompten kör du nu mot hela datasetet. Snittscore går upp eller ner. Du har bevis för effekten, och du upptäcker regressioner direkt. Det är skillnaden mellan att putsa enskilda diamanter och att slipa hela rågruvan på en gång.
Den här praktiken kommer från eval-världen, men den hör hemma redan på prompt-utvecklingsstadiet. Du behöver inte vänta tills agenten är i prod. Och även om prompten du jobbar på är en del av en större harness eller använder skills och verktyg, gäller samma princip: du behöver mätbar feedback för att veta att en ändring är en förbättring.
Eval-pipelinen som ryggrad
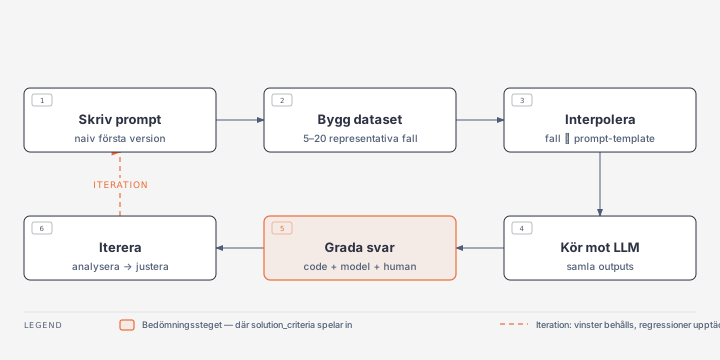
Pipelinen har sex steg:
- Skriv en initial prompt. En första version, gärna ärligt naiv så det finns lyft att hämta.
- Bygg ett dataset. 5–20 fall, antingen handgjorda eller LLM-genererade. Varje fall innehåller input (det prompten ska bearbeta) och kriterier (vad som gör svaret rätt).
- Interpolera datasetet i prompten. Varje fall fyller i de variabla delarna.
- Kör mot LLM. För varje fall, hämta agentens svar.
- Grada svaren. Antingen kodbaserat (parse + jämför), modellbaserat (en till LLM-anrop som scorar), eller manuellt.
- Iterera. Analysera lågscore-fallen, justera prompten, kör om hela datasetet.
Två detaljer som ofta missas:
Datasetet ska vara stabilt mellan iterationer. Annars jämför du äpplen och päron. Spara det till disk första gången du genererar det, ladda det därefter. Sätt också temperatur till 0 i grader-anropet: du vill ha konsistens i bedömningen, inte kreativitet.
Modellbaserade graders behöver ankarpunkter. Be aldrig modellen om bara en siffra ("Score 1–10:"). Den driftar mot 5–7 som default. Be istället om strengths, weaknesses och reasoning före scoren. Då tvingar du fram ett resonemang innan bedömningen, och scoren blir konsekvent.
Fyra tekniker, mätbar progression
Det finns fyra grundtekniker som tillsammans kan lyfta en prompts kvalitetspoäng från 2–3 till 7–8 i en typisk eval. Jag går igenom dem i samma ordning du applicerar dem.
Som löpande exempel använder jag en prompt som ska generera en endags måltidsplan för en atlet. Inputen är atletens profil (längd, vikt, mål, restriktioner). Bedömningen sker av en model grader som vet de förväntade kalorimängderna och näringsbehoven per case.
1. Clear & Direct
En naiv prompt börjar ofta med en artighet:
Kan du hjälpa mig med en måltidsplan för en atlet?
{profile}
Det låter ödmjukt men berättar inte för modellen vad du faktiskt vill ha. Den första raden ska vara ett action verb + tydlig task + output-spec:
Generate a one-day meal plan in Swedish for the athlete described below.
Output the plan as a structured day with breakfast, lunch, dinner, and 2 snacks.

Athlete profile: {profile}
Bara denna ändring lyfter typiskt scoren från ~3 till ~5. Du har eliminerat tvetydighet om format och leverans.
2. Being Specific — Type A och Type B
Specificitet kommer i två varianter och de löser olika problem.
Type A (attributes). Egenskaper du vill se i outputen. Längd, struktur, format, namngivna fält:
Output requirements:
- Total daily calories explicitly stated
- Protein, carbs, and fat in grams per meal
- All foods commonly available in Swedish supermarkets
- Each meal should have a brief rationale (1 sentence)
Type B (steps). Stegen du vill att modellen ska följa när den resonerar fram svaret: en intern struktur du tvingar fram för att den ska överväga rätt saker, inte en process modellen ska visa upp för användaren:
Reasoning steps:
1. First estimate the athlete's daily caloric needs based on weight, training volume, and goals
2. Identify any dietary restrictions or special needs from the profile
3. Determine optimal macro distribution for their sport
4. Build the meal plan, ensuring totals match the caloric estimate
5. Verify each meal accommodates the restrictions identified
Type A passar nästan alla prompts. Type B är värt mödan när problemet är komplext nog att modellen annars hoppar över viktiga perspektiv.
Tillsammans tar de typiskt scoren till ~6–7.
3. XML Tags — separera prompten från datat
När prompten växer börjar den blanda instruktioner med interpolerat data. Det förvirrar modellen om var den ena slutar och den andra börjar:
<athlete_profile>
{profile}
</athlete_profile>

<output_requirements>
- Total daily calories explicitly stated
- ...
</output_requirements>

<reasoning_steps>
1. ...
</reasoning_steps>
XML-taggar är avgränsare, inte estetik. Modellen tränas på enorma mängder strukturerad data där taggar separerar olika typer av innehåll. Att använda dem i din prompt är att tala modellens modersmål. Det är samma princip som systeminstruktioner följer: tydlig strukturell separation hjälper modellen göra rätt.
Lyftet från XML är mindre dramatiskt än de tidigare teknikerna men stabilt. Och det blir större ju mer komplex prompten är.
4. Few-shot Examples — visa, motivera, placera
Den fjärde tekniken är att inkludera ett eller flera input/output-exempel. Här gör många fel på två sätt:
Placering: exempel ska komma efter instruktionerna, inte före. Annars tolkar modellen exemplen som del av formatet snarare än som inspirationsmall.
Motivering: exemplen måste innehålla varför de är ideala, inte bara hur de ser ut. Annars härmar modellen formen utan att förstå substansen.
<example>
<input_profile>Cyklist, man, 35 år, 72 kg, tränar 10h/vecka. Laktosintolerant.</input_profile>
<ideal_output>
**Daglig totaløversikt:** ~3200 kcal, 130g protein, 450g kolhydrater, 95g fett.
...
</ideal_output>
<why_this_is_ideal>
This response is ideal because: (1) explicit total calories that match the profile's training volume, (2) macro breakdown per meal makes verification trivial, (3) handles laktosintolerans implicitly by avoiding dairy without making it a footnote, (4) Swedish supermarket-foods (lingonsylt, havregryn) feel realistic, (5) rationale per meal teaches the athlete the *why*, not just the what.
</why_this_is_ideal>
</example>
<why_this_is_ideal>-blocket är vad som compounderar kvalitet. Modellen lär sig vad som gör outputen bra, inte bara hur en bra output ser ut.
Med alla fyra teknikerna applicerade når en typisk prompt 7–8 av 10. Det är ungefär 3× lyft från utgångsläget, utan att byta modell, sänka temperaturen eller på något sätt köpa mer kraft.
Anti-mönster
Det finns tre vanliga fel som förstör eval-driven iteration även om man har pipelinen på plats:
1. Be aldrig grader om bara score.
"Bedöm denna output 1-10" → modellen skriver 7 och har gjort sitt. Den har inte tänkt. Be om strengths, weaknesses, reasoning innan score. Då tvingar du fram resonemang.
2. Iterera inte utan stabilt dataset. Om du regenererar datasetet mellan iterationer jämför du två olika populationer och vet inte om det är prompten eller fallen som ändrats. Spara datasetet till disk första gången, ladda det därefter.
3. Överoptimera inte mot enstaka case. Om du ser ett enskilt fall få låg score är det frestande att ändra prompten specifikt för det fallet. Men prompten ska generalisera. Kolla om det är ett systematiskt mönster (3+ case med samma typ av brist) innan du ändrar något.
Verktygen jag använder
Jag har byggt en återanvändbar PromptEvaluator-klass som kapslar in hela pipelinen. Hela strukturen är runt 200 rader Python. Det intressanta är arkitekturen:
Two-step dataset-generering. Först genereras idéer (kort beskrivande sträng per case), sedan expanderas varje idé till ett fullt test case med inputs och kriterier. Det ger mer diversitet än ett one-shot generations-anrop som tenderar att skapa likartade variationer.
run_promptsom argument. Själva prompten under test passas in som funktion. Frameworket vet inte vad prompten gör, bara hur den anropas och bedöms. Direkt återanvändbar för nästa projekt.Concurrent execution. Alla cases körs parallellt via
concurrent.futures.ThreadPoolExecutor. Datasetet på 50 cases tar 5× längre tid sekventiellt än med 5 parallella workers. Watch the rate limits.HTML-rapport. Efter varje körning skrivs en
output.htmlmed tre statistik-rutor (totalt antal cases, snitt-score, pass rate ≥7) och en tabell med färgkodade scores. Stakeholder-vänligt format som gör eval-arbetet synligt.Scoring brackets explicit. Gradern får ankarpunkter: 1–3 = fail på obligatoriska krav, 4–6 = uppfyller obligatoriska men brister i sekundära, 7–8 = de flesta kriterier uppfyllda, 9–10 = ideal. Utan brackets driftar gradern fortfarande, även med strengths/weaknesses-promptmönstret.
extra_criteriaför obligatoriska krav. Vid grading kan man peka ut icke-förhandlingsbara krav. Brott mot dem ger automatiskt score ≤3, oavsett hur bra resten är. Bra för "outputen måste vara giltig JSON" eller "alla namngivna fält måste finnas".
Det är ett mönster värt att stjäla rakt av. Hela klassen är tunn nog att lägga in i vilket projekt som helst där en prompt är central.
I praktiken
Om du ska börja praktisera eval-driven prompt engineering på en av dina egna prompts, här är ordningen:
Samla 5 riktiga case av input som prompten ska hantera, inte syntetiska. Det räcker som första dataset.
Definiera kriterier per case. Vad ska outputen innehålla för att vara godkänd just för det här caset? Skriv det som korta påståenden, 2–4 per case.
Skriv en naiv första version av prompten. Den ska vara ärligt enkel: bara handeln. Du vill ha låg baseline.
Bygg en enkel eval-loop. Antingen från scratch (en
for-loop räcker), eller använd ett ramverk somPromptEvaluator-mönstret ovan. Skriv en model-grader-prompt som ber om strengths/weaknesses/reasoning innan score.Kör baseline-evaln. Notera snittet. Det är din golvnivå.
Applicera teknikerna i ordning. Clear & Direct → Type A specificitet → Type B steps → XML → Examples. Kör eval mellan varje. Behåll de tekniker som ger lyft, kasta de som inte gör det.
Inspektera de svagaste casen. Om scoren plateauar är det dags för djupanalys. Vad har de gemensamt? Är det en speciell input-kategori? En typ av krav som prompten inte hanterar?
Det här är inte ett engångsarbete. När prompten är i prod är eval-pipelinen din regression-testning: varje ändring kör du genom samma loop, varje försämring blir synlig.
Relaterade artiklar
- agent-evals-i-praktiken — Den filosofiska och case-baserade genomgången av evals; denna artikel handlar om implementationen