När agenter börjar drömma — Anthropics minnessystem gör context-repot till infrastruktur
Minne har varit ett gör-det-själv-mönster: CLAUDE.md och en mapp med filer. Nu produktifierar Anthropic det i Managed Agents: delade minnesstores med versionshantering, plus Dreaming, en nattlig agent som städar minnet mellan sessioner.
Nyckelinsikter
- Anthropics nya minnessystem är filer på ett filsystem med versionshantering, plus en schemalagd agent som städar dem. Det är samma context-repo-mönster många redan handbygger, men som hanterad infrastruktur.
- En memory store är en workspace-scopad mapp med textfiler som monteras i agentens container. Agenten läser och skriver den med samma filverktyg den använder för allt annat. Minnet är filsystemet, inte en separat databas.
- Dreaming är en batch-process byggd på Managed Agents: en agent-session vars enda uppgift är att gå igenom dagens sessionsloggar, hitta mönster (återkommande misstag, konvergerade arbetsflöden, gemensamma preferenser) och kurera minnesfilerna mellan körningar.
- Det stora skiftet är riktningen: från uppgiftsminne (en agents anteckningar) till organisationsminne (delad kunskap över en flotta agenter). Det som agent A lär sig kan agent B och C läsa nästa gång de startar.
- Read_write är default men farligt med otillförlitlig input: en lyckad prompt injection kan skriva skadligt innehåll i minnet som senare sessioner läser som betrodd sanning. Referensmaterial bör vara read_only.
Sammanfattning
Sedan Claude Code släpptes våren 2025 har jag handbyggt minne åt mina agenter med en mapp full av markdown-filer, inte med en databas. Ett context-repo: en CLAUDE.md som beskriver projektet, en mapp med mötesanteckningar, en med analyser. Varje ny fil gör agenten lite kunnigare, utan modellbyte och utan kodändring. Det fungerar förvånansvärt bra, och under huven är det inget mer än filer som en agent kan läsa och skriva.
Nu har Anthropic produktifierat precis det mönstret. I Managed Agents finns memory stores: workspace-scopade mappar med textfiler som monteras direkt i agentens container, plus versionshantering, åtkomststyrning och spårbarhet ovanpå. Och så det som fått mest uppmärksamhet: Dreaming, en schemalagd process som går igenom dagens sessionsloggar och städar minnet mellan körningar, så nästa dags agenter startar smartare.
Tre saker bär hela systemet: filer på ett filsystem, versionshantering på de filerna, och en agent vars enda jobb är att hålla dem i ordning. Den här artikeln tar dem en i taget.
Tidslinjen: agentens byggstenar
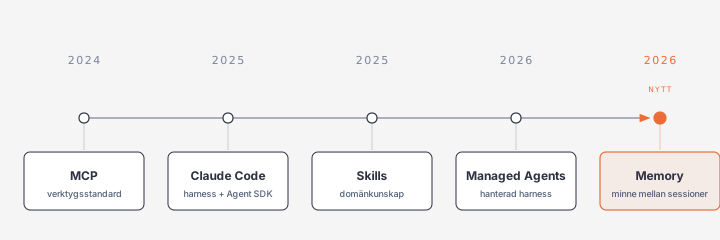
Det är lättare att förstå minne om man ser var det landar i Anthropics följd av byggstenar. Varje primitiv har löst en konkret begränsning:
- MCP (2024). Ett standardiserat sätt att koppla agenten till externa verktyg och data. USB-C för agenter.
- Claude Code + Agent SDK (2025). En harness som gör en agent av en modell: verktyg, agentloop, kontexthantering.
- Skills (2025). Domänkunskap som markdown-filer, laddade vid behov. Domänexperten i rummet.
- Managed Agents (2026). En hanterad harness där Anthropic kör infrastrukturen åt dig: sessioner, miljöer, verktyg.
- Memory (2026). Det som gör att agenten kan veta vad som hände igår.
Minnet kommer sist i följden, och det är logiskt: det vilar på allt det andra. En harness som kan läsa och skriva filer, verktyg som ger åtkomst, och nu en hanterad miljö där flera agenter delar samma lagring. Först när de bitarna sitter blir minne meningsfullt att bygga.
Hur agentminnet utvecklats
En språkmodell har inget inbyggt minne mellan sessioner. Varje ny konversation börjar med ett tomt blad. Allt minne måste byggas utanför modellen, och sättet vi gjort det på har utvecklats i tydliga steg:
- CLAUDE.md: en fil. Konventioner, preferenser, projektöversikt i en enda fil som laddas automatiskt. Enkelt, men platt.
- Memory tool: minne som verktyg. Ett API där modellen anropar
memory_read(),memory_write(),memory_edit()för att spara och hämta information mellan turer. Minnet blev något agenten aktivt hanterar, inte bara läser. - Skills: procedurminne.
SKILL.md-filer som beskriver hur man gör något: färdigheter att tillämpa, snarare än fakta att minnas. memory/: filer agenter både läser och skriver. En mapp med filer som agenten själv kurerar över tid:notes/,deploy.md,team-rules.md.
Det fjärde steget är det Anthropic nu kallar "memory". Det är samma sak jag ser dagligen i Claude Code: Claude hittar en fil i mitt kodrepo, läser den, skapar en ny. Filsystemet är minnet. Det som tillkommit är infrastrukturen runt filerna, och det är där resten av artikeln lägger tiden.
Minnesstores: delat, scope-styrt, granskbart
En memory store är en workspace-scopad samling textdokument. När du kopplar en store till en session monteras den som en mapp i sessionens container (under /mnt/memory/) och agenten läser och skriver den med exakt samma filverktyg den använder för allt annat. En kort notis om varje monterad store läggs automatiskt in i systemprompten, så agenten vet var den ska titta.
Det som lyfter detta från "en mapp med filer" till infrastruktur är tre saker.
Åtkomststyrning och delning
En store kopplas med access: read_only eller read_write (default), och åtkomsten upprätthålls på filsystemsnivå. Upp till 8 stores kan kopplas per session. Det öppnar för en arkitektur där olika delar av minnet har olika ägare:
- En read-only store med organisationens konventioner, standarder och domänkunskap, delad till många sessioner men omöjlig för en agent att ändra.
- En read-write store där teamets agenter antecknar löpande lärdomar.
Det här är multi-agent-vinkeln: en store, många agenter. När agent A löser en bugg eller kartlägger ett dataset skriver den lärdomen till en minnesfil. Agent B och C läser den nästa gång de startar och slipper göra om utforskningen. Skrivningar synkas tillbaka till storen och hålls i synk mellan sessioner som delar den.
Optimistisk samtidighet
Flera agenter kan skriva till samma fil utan att skriva över varandra. Lösningen är välbekant för alla som jobbat med versionshantering: en content_sha256-precondition. En skrivning går bara igenom om innehållets hash fortfarande matchar den du läste. Vid krock får du läsa om och försöka igen mot färskt tillstånd. Agenter kan alltså skriva till samma minne utan att radera varandras lärdomar.
Versionshantering och spårbarhet
Varje ändring av en minnesfil skapar en oföränderlig memory version. Det ger en revisionshistorik: vem ändrade vad och när, möjlighet att inspektera eller återställa ett tidigare läge, och, för efterlevnad, att redigera bort känsligt innehåll ur historiken (läckta hemligheter, PII) utan att förstöra spåret. Versioner tillhör storen, inte den enskilda filen, så de överlever även om filen raderas. (I betan behålls historik i 30 dagar.)
Resultatet är att en minnesfil inte längre är en svart låda. Du kan öppna deploy.md, se att den gått från v1 till v4, läsa att raden "Deploya via make ship, inte ./deploy.sh" skrevs av en specifik session med motiveringen "användaren korrigerade detta i PR #412, #418, #431". Minnet är granskbart på samma sätt som kod i git.
En sak att tänka på: read_write är default. Får agenten in otillförlitlig input kan en lyckad prompt-injection skriva skadligt innehåll i minnet, som nästa session sedan läser som betrodd sanning. Därför hör referensmaterial och delade uppslagsverk hemma i en
read_only-store.
Dreaming — agenten som städar minnet på natten
Ett minne som bara växer blir snabbt rörigt: dubbletter, motstridiga anteckningar, fragment som ingen sammanfattat. Människans hjärna löser det under sömnen: den konsoliderar dagens intryck, sorterar bort brus och flyttar det viktiga till långtidsminnet. Anthropic har lånat både mekanismen och namnet.
Dreaming är en schemalagd process (den körs på intervall eller triggas av en händelse) som går igenom agenternas sessionsloggar och kurerar minnesstoren. Den letar efter tre sorters mönster:
- Återkommande misstag agenten gör om och om igen.
- Arbetsflöden agenten konvergerar mot över olika uppgifter.
- Preferenser som vuxit fram tvärs över ett team av agenter.
Det den hittar skrivs tillbaka som nya, organiserade lärdomar. Nästa dags sessioner startar därmed med ett städat, berikat minne, automatiskt smartare utan att någon människa skrivit en rad.
Och Dreaming är i sig byggt på Managed Agents. Det är en agent-session vars enda uppgift är att läsa sessionsloggar och redigera minnesfiler: samma harness, samma filverktyg, samma versionshantering som vilken annan agent som helst. Det enda som skiljer är uppgiften, att kurera minne istället för att lösa kundens problem.
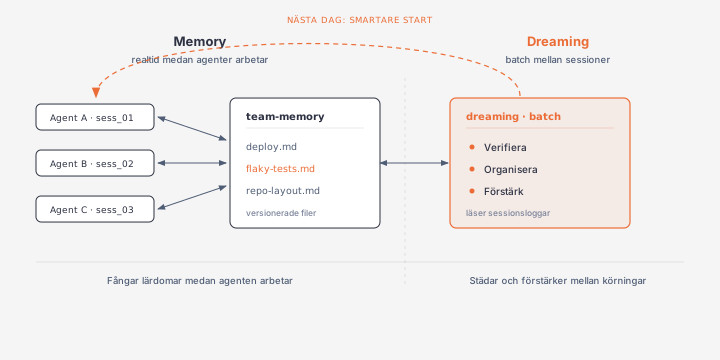
De två halvorna bildar ett system: Memory till vänster låter varje agent anteckna lärdomar i realtid medan den arbetar. Dreaming till höger verifierar, organiserar och förstärker de lärdomarna i batch mellan sessioner.
Effekten kan vara stor. Det juridik-AI-bolaget Harvey rapporterade ungefär 6x högre task completion efter att ha infört Dreaming. Dreaming är i skrivande stund en research preview.
Från uppgiftsminne till organisationsminne
Bortom mekaniken (versioner, scopes, scheman) finns en riktning: minnet rör sig från det lilla till det stora.
Det börjar som uppgiftsminne: en task-notes.md med småsaker som "föredrar punktlistor", "tidszon PT" och "fråga innan du skickar". Sedan kureras det till en organiserad memory/-struktur: conventions.md, tasks/, people/, tools/. Och i takt med att ett företag driftsätter flottor av agenter blir minnet till slut organisationsminne: agentens samlade förståelse för hur hela verksamheten fungerar. Stordriftsdelning, bidrag från många agenter, och Dreaming som håller helheten i ordning.
Det är en bekant kurva för den som byggt context-repon. Jag har sett samma sak i kundprojekt: det börjar med en enda CLAUDE.md, växer till en mappstruktur, och blir efter ett tag den mest värdefulla tillgången i projektet, mer värdefull än någon enskild prompt eller modellval. Skillnaden nu är att Anthropic erbjuder infrastrukturen för att skala det bortom ett enskilt projekt, till en hel organisation, med flera agenter som bidrar samtidigt.
I praktiken
Handbygger du redan context-repo (CLAUDE.md + mappstruktur) har du redan det mesta av värdet. Anthropics produktifiering bekräftar mönstret snarare än ersätter det. Det memory stores lägger till är delning mellan flera agenter och en granskbar historik, relevant först när det behovet finns.
Kör du flera agenter som rör samma kunskap är det här memory stores tjänar in sig: organisationens stabila kunskap i en read_only-store, ett read_write-utrymme per team eller projekt, och ett gemensamt minne som växer av sig självt. Defaulten är read_write, värt en titt innan en agent med otillförlitlig input får skrivrättigheter den inte behöver.
Är du beställare och hör "agenten lär sig över tid", be om att få se minnet. Du får tillbaka en mapp med markdown-filer och en ändringslogg: vilka filer som finns, vem som skrivit till dem, vad som ändrats och när. En text att läsa och ifrågasätta, inte en svart låda.
Systemet är filer, en historik, och en agent som städar dem. Med den bilden på plats blir det enklare att se vad som kan gå fel, och vad som är värt att bygga.
Källor och vidare läsning
Se källorna i artikelns metadata för originalreferenser.
Källor
Relaterade artiklar
- harness-design-principer — Minnet är ett av de lager harnessen hanterar; den här artikeln zoomar in på det
- ai-agenternas-byggmaterial — Minne som ett av sex byggmaterial; här blir det hanterad infrastruktur