Harnessen — det osynliga lagret som avgör om din AI-agent fungerar
Lagret mellan dig och AI:n bygger kontexten, väljer verktyg, komprimerar konversationen och hanterar säkerheten. Här listar jag vad en modern harness gör, kapabilitet för kapabilitet.
Nyckelinsikter
- En harness är lagret mellan användaren och modellen som omvandlar 5 tokens input till 20 000 tokens kontext. Det är det som gör en agent av en chatbot.
- De flesta använder AI genom att chatta in kontext manuellt. Nästa steg är att peka AI:n mot en mapp med filer, där harnessen tar över kontextbygget.
- En modern harness hanterar allt från prompt-konstruktion och verktygsval till säkerhet och kostnadsoptimering.
- Prompt enrichment (den automatiska kontextkonstruktionen) avgör mer än modellvalet.
- Skills (markdown-filer med domänkunskap) separeras från harnessen. Det innebär att domänexperter kan förbättra agenten utan att röra infrastrukturen.
Sammanfattning
Jag satt nyligen på en middag där samtalet föll på AI. De flesta runt bordet använde ChatGPT ungefär som en smart Google: ställ en fråga, få ett svar, ställ en följdfråga, chatta in mer kontext. Det fungerar, men det kräver att du gör jobbet med att bygga upp kontexten.
Mina kunder har börjat göra något annorlunda. De pekar Claude mot en mapp med filer (projektdokumentation, specifikationer, mejltrådar) och låter AI:n själv söka, läsa och förstå kontexten. Det som driver skillnaden i resultat är harnessen, det osynliga lagret mellan dig och AI:n.
Den här artikeln går igenom vad en harness gör, kapabilitet för kapabilitet.
Från chattfönster till arbetsmapp
Det finns en naturlig progression i hur människor använder AI:
Steg 1: Chattfönstret. Du skriver en fråga. AI:n svarar. Du korrigerar, lägger till kontext, frågar igen. All kontext byggs manuellt genom konversationen. Det här är ChatGPT-modellen, och det är så de flesta fortfarande arbetar.
Steg 2: Arbetsmappen. Du pekar AI:n mot en mapp med filer. Istället för att du chattar in kontext, navigerar AI:n själv bland filerna: söker, läser, skapar. Det här är Claude Cowork-modellen, och det är hit teknikintresserade personer på svenska bolag börjar röra sig.
Steg 2 fungerar bättre för att det finns en harness under ytan som gör det tunga lyftet. Om Claude är en bättre modell än GPT-5.4 kan diskuteras, men det är inte där skillnaden ligger.
Vad är en harness?
Jag har ett context-repo för varje kundprojekt. Typiskt ser det ut så här:
kund-x-context/
├── CLAUDE.md              ← Projektbeskrivning och konventioner
├── _kund/
│   └── verksamhet.md      ← Kundens domän, produkter, organisation
├── ai/
│   ├── moten/
│   │   ├── 2026-01-30-kickoff.md
│   │   └── 2026-03-05-agentvalidering.md
│   └── arbete/
│       └── eval/          ← Resultat, benchmarks, feedback
När jag öppnar den här mappen i Claude Cowork skriver jag tolv ord: "sammanfatta var vi står inför nästa kundmöte". Innan de femton tokens når modellen har harnessen konstruerat ett API-anrop på uppemot 20 000–35 000 tokens.
Claude läser CLAUDE.md och förstår att det här är ett industrivärmeprojekt i PoC-fas. Den söker igenom mötesanteckningarna, hittar de senaste besluten, läser eval-resultaten, och producerar en sammanfattning med rätt detaljeringsnivå. Jag behövde inte chatta in kontexten. Den fanns redan i filerna, och harnessen visste hur den skulle använda den.
Det här är prompt-enrichment.
Allt harnessen gör
Det som överraskade mig mest när jag började dissekera hur Claude Code och liknande verktyg fungerar var bredden: dussintals samverkande system. Här är en genomgång av vad som pågår under ytan.
Prompt-konstruktion
Innan din fråga når modellen har harnessen byggt ihop en kontext:
- Systemprompt från ~110 villkorliga fragment. Prompten sätts ihop dynamiskt efter vad du gör: vilka verktyg som är aktiva, vilken miljö du är i, vilka filer som finns.
- Projektkontext. CLAUDE.md-filer laddas automatiskt. Git-status, datum och miljöinformation injiceras.
- 18+ verktygsdefinitioner. Filläsning, sökning, redigering, webbhämtning, kodexekvering. Totalt 14 000–17 000 tokens bara för att beskriva vad agenten kan göra.
- Progressiv skill-laddning. Domänkunskap laddas i steg: först bara namn och beskrivning, sedan full content vid behov. Det sparar kontext tills den faktiskt behövs.
Verktyg och exekvering
En agent som bara kan svara med text är en chatbot. En harness ger agenten händer:
- Filsystemåtkomst. Läsa, skriva, söka, navigera bland lokala filer med scopade rättigheter.
- Kodexekvering. Köra Python, bash, och andra kommandon med sandboxning.
- Webbsökning och hämtning. Söka på webben och hämta innehåll från URL:er.
- Browserautomation. Styra webbläsare via MCP-servrar för interaktion med webbapplikationer.
- Extern integration. Ansluta till API:er, databaser, molnlagring, och andra system via MCP.
Men det räcker inte att ha verktygen. Harnessen bestämmer vilka verktyg som laddas, när de blir tillgängliga, och hur de presenteras för modellen:
- Deferred tool loading. Verktyg listas först bara som namn. Fullständiga scheman hämtas vid behov. Det minskar initial kontext.
- Pre/post-tool hooks. Harnessen kan intercepta verktygsanrop före och efter exekvering. Validering, loggning, säkerhetskontroller.
- Verktygsrouting baserat på kontext. Vilka verktyg som injiceras beror på situation, aktiva skills, och användarens rättigheter.
Konversationshantering
En lång arbetssession med en agent innebär att kontexten växer. Utan hantering slutar agenten fungera när fönstret tar slut:
- Kontextkompaktering. När konversationen närmar sig fönstrets gräns (~98%) aktiveras automatisk kompaktering — fem olika strategier beroende på situation. Från att kollapsa stora tool-outputs till att sammanfatta hela konversationshistoriken. Du märker det knappt.
- System reminders. Instruktioner re-injiceras under konversationen för att motverka att de tappar inflytande på avstånd. Modellen har en tendens att "glömma" instruktioner som gavs tidigt. Harnessen kompenserar.
- Session-resumption. Kunna fortsätta en tidigare session från sparat tillstånd. (En form av minne.)
Människa-i-loopen
En agent som agerar helt utan kontroll är en risk. Harnessen hanterar samspelet:
- Godkännandeflöden. Blockera åtgärder tills användaren ger tillåtelse. Filskrivningar, externa anrop, destruktiva kommandon.
- Rättighetssystem. Konfigurerbara åtkomstnivåer. Från enbart läsning till full autonomi, med allt däremellan.
- Klarfrågor. Agenten kan pausa, ställa en fråga, och vänta på svar innan den fortsätter.
- Uppgiftsspårning. Automatiskt skapa och uppdatera uppgiftslistor så användaren ser var agenten befinner sig.
Multi-agent-orkestrering
Komplexa uppgifter kräver att flera agenter samarbetar (multi-agent):
- Delegering till subagenter. Spawna specialiserade agenter med isolerade kontexter.
- Parallell exekvering. Skicka delar av arbetet till flera agenter samtidigt och aggregera resultat.
- Handoff och routing. Dirigera till rätt specialist baserat på vad uppgiften kräver.
- Plan-and-delegate. En koordinerande agent skapar en plan, delegerar steg, och övervakar genomförande.
Kostnadsoptimering
Utan optimering blir agentkörningar snabbt dyra:
- Prompt caching. Harnessen optimerar automatiskt för Anthropics cache-system. Efter första anropet i en konversation reduceras inputkostnaden med upp till 90%. Det sker utan att du gör något.
- Progressiv context disclosure. Ladda bara den information som behövs, skjut upp resten.
- Modellval per uppgift. Billigare modeller för enklare uppgifter, större för komplexa.
Säkerhet
I produktion krävs kontroll:
- Prompt injection-försvar. Inputvalidering, verktygsfiltrering, modulär komponentstruktur. (Se även guardrails.)
- Verktygsisolering. Begränsa verktyg via vitlistor, hooks, och parametriserad åtkomst.
- Nätverksisolering. Begränsa utgående anslutningar till specifika endpoints.
- PII-filtrering. Ta bort persondata innan agenten ser den.
- Granskningsloggning. Spåra alla verktygsanrop, API-åtkomst, och agentbeslut.
Att bygga det själv
Varje punkt ovan är ett problem som behöver lösas för att en agent ska fungera pålitligt i produktion. Det är lätt att underskatta. De flesta av oss gör det initialt, inklusive jag.
Anthropic har ett helt team som arbetar med sin harness, med 2–3 releaser per vecka. Vid senaste räkningen 358 releaser totalt. Varje release förbättrar skill-aktivering, kontextkompaktering, verktygsval, säkerhetspolicyer.
Det går att bygga själv. Men det är värt att förstå vad som ingår innan man tar det beslutet.
Separation av harness och skills
Det viktigaste arkitekturbeslutet i Anthropics design är separationen mellan harness och skills.
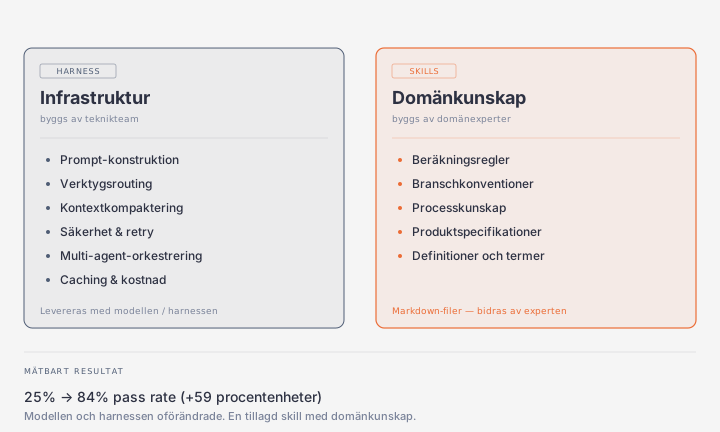
Harnessen hanterar infrastruktur: kontextbygge, verktygsrouting, kompaktering, retry, caching, säkerhet, orkestrering. Det är listan ovan.
Skills hanterar domänkunskap: vad agenten vet om ditt specifika område — era produkter, era processer, era beslut. Det här underhålls av dig, eller av domänexperten direkt.
Skills är markdown-filer: text som beskriver kunskap, process och instruktioner, utan en rad kod. Det innebär att en produktspecialist, en kalkylchef, eller en innesäljare kan förbättra agentens domänkunskap utan att röra infrastrukturen.
I ett kundprojekt gick agenten från 25% till 84% pass rate, +59 procentenheter mätt med evals, bara genom att lägga till en skill med domänkunskap. Modellen var densamma. Harnessen var densamma. Det enda som ändrades var en markdown-fil.
Vad detta innebär för dig
Om du idag använder AI genom att chatta in kontext manuellt, prova att peka den mot en arbetsmapp istället. Claude Cowork gör precis detta. Skillnaden kommer av att hela listan ovan arbetar bakom kulisserna.
Om du funderar på agentlösningar för verksamheten, ta med dig den här listan in i diskussionen som underlag för vad som behöver finnas på plats. Då blir valet medvetet: lägger ni tiden på infrastrukturen som driver agenten, eller på den domänkunskap som gör den värdefull just för er?
Källor och vidare läsning
Se källorna i artikelns metadata för originalreferenser.
Källor
Relaterade artiklar
- agent-evals-i-praktiken — Evals testar det som harnessen producerar