Första och andra generationens AI-stöd — från chattfönstret till det växande arkivet
Den första generationen är chattfönstret: du laddar upp filer, får ett svar, och allt försvinner när du stänger. Den andra pekar AI:n mot en mapp den läser och skriver i själv, och projektet får ett minne som växer för varje session.
Nyckelinsikter
- Första generationens AI-stöd är chattfönstret: manuell uppladdning, ett svar, och kontext som dör när sessionen stängs. Minnet bärs av personen framför skärmen, inte av systemet.
- Andra generationens AI-stöd pekar AI:n mot en synkad mapp med filer som den läser och skriver i själv via en harness. Projektets minne flyttar från personen till ett arkiv som växer för varje session.
- Generationerna skiljs åt av minnessystemet: samma arbete ger antingen fyra isolerade gissningar eller ett gemensamt, växande arkiv.
- En CLAUDE.md som läses vid varje sessionsstart fungerar som projektets gemensamma minne; nya versioner skrivs till mappen och synkas till kollegor, vilket ger spårbarhet utan att man bygger en applikation.
- Vägen dit går via en mognadstrappa: börja med en ensam användare mot en synkad mapp, öppna läs-vyer för fler när det är stabilt, automatisera sist. Hoppa inte direkt till toppen.
Sammanfattning
De flesta möter AI genom ett chattfönster. Man öppnar ChatGPT, Claude eller Copilot i webbläsaren, laddar upp de filer frågan rör, får ett svar, kopierar ut det. Nästa gång laddar man upp samma filer igen. När fliken stängs är sammanhanget borta. Det är första generationens generella AI-stöd, och det bär en hel verksamhet på axlarna av personen framför skärmen.
Andra generationen vänder på flödet. I stället för att klistra in kontext pekar man AI:n mot en mapp den får läsa och skriva i själv. En harness läser en CLAUDE.md vid varje sessionsstart, söker i underlaget, skriver nya versioner tillbaka till mappen och loggar besluten. Filerna synkas så att kollegor kan följa med. Ingen applikation byggs, men projektet får ett minne som lever i mappen och växer för varje session.
Modellen är densamma i båda fallen. Det som skiljer är var minnet bor: hos en person, eller i ett arkiv. Den här artikeln går igenom de två generationerna, varför minnet är hela skillnaden, och hur man tar sig från den ena till den andra utan att snubbla.
Första generationen — chattfönstret
Så här ser det vanligaste AI-arbetet ut idag. En person öppnar en chatt, laddar upp ett par PDF:er och ett kalkylark, ställer sin fråga och får ett svar. Svaret klistras in i ett Word-dokument. Imorgon, i en ny session, laddas samma filer upp igen. Chatten minns ingenting från igår.
Jag arbetar i ett projekt kring en stor markexploatering: ett samägt bolag, ett konsultteam på ett par dussin personer, utredningar på hundratals sidor. Hela projektminnet låg hos projektledaren. Varje session började från noll: ladda upp utredningarna på nytt, förklara sammanhanget igen, få ett resultat, klistra in det någonstans. Fyra parallella chattsessioner under fyra arbetsdagar, inget delat minne med någon annan. "Var var vi nu igen?" var den återkommande frågan.
Mönstret har tre svaga punkter:
- Kontexten dör vid stängning. Allt man matat in är borta nästa gång. Arbetet börjar om från noll varje session.
- Personen är minnet. Den som sitter vid skärmen är det enda som håller ihop projektet — vilka filer som gäller, vad som beslutats, var resultatet hamnade. Blir den personen sjuk stannar allt.
- Outputen blir lösa filer. Svaren landar som Word-dokument utan versionsspår. Ingen vet vilken version som är den senaste, eller varför något ändrades.
Stödet fungerar för en enskild fråga, en enskild gång. Men det skalar inte över tid, och det skalar inte till fler människor.
Andra generationen — en harness mot en mapp
Andra generationen byter ut den manuella uppladdningen mot tillgång. Ett skrivbordsprogram (Claude Desktop eller Claude Cowork) får läsa och skriva i en mapp som synkas via OneDrive eller SharePoint. Sedan tar harnessen över.
Vid varje sessionsstart läser den en CLAUDE.md: projektets gemensamma minne och konstitution, en text som beskriver vad projektet är, vilka begrepp som gäller och hur saker ska göras. Den söker igenom underlagsmappen efter det som är relevant för frågan, skriver nya versioner till leveransmappen, och loggar vägval i en beslutslogg. Filerna synkas tillbaka till SharePoint, så att kollegorna och konsulterna kan följa med. Backup och spårbarhet sköts av filytan, inte av ett bygge.
I samma markexploateringsprojekt blev frågan "var var vi nu igen?" till ett svar på några sekunder. En ny utredning som läggs i mappen är genast en del av bilden: AI:n letar upp den, läser den, väver in den. Inget laddas upp på nytt. Och ingen applikation skrevs: intelligensen är samma generella modell, men projektet har nu ett minne som ligger i mappen i stället för i ett huvud.
Det här är samma steg som harnessen gör möjligt i allmänhet: att peka AI:n mot en mapp med filer och låta den bygga kontexten själv, i stället för att man matar in den för hand. Andra generationen är det steget taget på allvar, för ett helt projekt.
Skillnaden är minnet
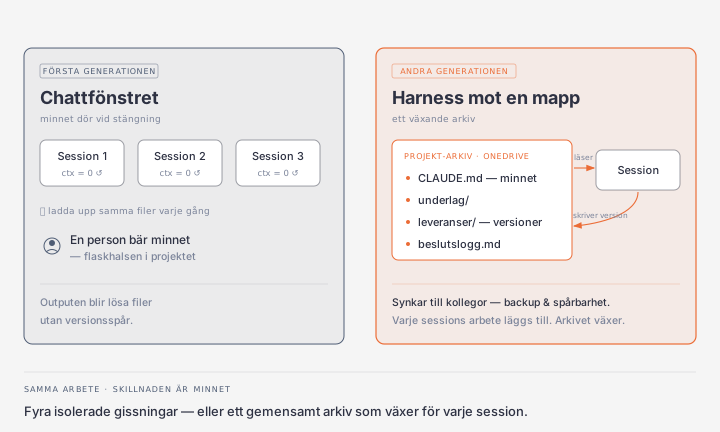
Lägg de två generationerna bredvid varandra över samma fyra arbetsdagar. I chattvärlden blir det fyra isolerade sessioner, var och en som börjar med tomt minne, fyra gissningar som inte vet om varandra. I harness-världen läggs varje sessions arbete till samma växande kropp: utredningen från måndag finns kvar på torsdag, beslutet som fattades på tisdag står i loggen, och varje ny fråga ställs mot allt som redan finns.
Skillnaden är att minnet flyttat från personen till arkivet. Ett arkiv går att dela, granska och lämna över; ett minne i ett huvud gör inte det. En beställare som vill se projektets minne får tillbaka en mapp med markdown-filer och en ändringslogg, en text att läsa och ifrågasätta i stället för en svart låda.
Mognadstrappan — hoppa inte till toppen
Steget från första till andra generationen går via en trappa med fyra nivåer, och den lockar att hoppa över.
- Nivå 1: chatt med manuella uppladdningar. Där de flesta står idag. Personen bär minnet, och samma filer laddas upp om och om igen.
- Nivå 2: chatt som når filerna själv. Chatten kopplas mot SharePoint och M365 via MCP och slipper den manuella uppladdningen. Men sessionen är fortfarande utgångspunkten, och kontexten dör vid stängning. Bekvämare, men samma generation.
- Nivå 3: harness mot en synkad mapp, en användare. Här sker språnget: projektminnet flyttar från personen till arkivet. En person arbetar mot mappen; resten kan få en läs-vy när det är stabilt.
- Nivå 4: team-flöde med automation. Flera användare, schemalagda körningar, notifieringar, spårbarhet. Det här ligger längre fram, i storleksordningen ett år bort för ett projekt som börjar nu.
Den generella gränsen går mellan nivå 2 och 3. Nivå 2 tar bort uppladdningsfriktionen men låter minnet dö med sessionen. Det är fortfarande första generationen. Först på nivå 3, när minnet flyttar till arkivet, byter stödet generation.
Varje nivå bygger struktur som nästa lutar sig mot. Projektminnet på nivå 3 är det som automationen på nivå 4 hänger sin spårbarhet, sina triggers och sina team-vyer i. Utan det har toppen ingenting att fästa i. Den som hoppar direkt till automation bygger på lös sand. Vägen är att börja med en ensam användare mot en strukturerad mapp, öppna läs-vyer för fler när det sitter, och automatisera sist.
I praktiken
Att ta ett projekt från första till andra generationen kräver mindre teknik än man tror, och mer ordning.
- Ge AI:n en strukturerad mapp, inte tematiska högar. Ordningen ska spegla hur arbetet faktiskt rör sig.
- Skriv en CLAUDE.md som projektets konstitution: vad det här är, vilka begrepp som gäller, hur saker ska göras. Den växer med projektet.
- Lägg underlag och leveranser i var sin mapp, och för en beslutslogg så att arkivet vet inte bara vad som finns utan varför.
- Synka via OneDrive eller SharePoint för backup och spårbarhet: filytan gör jobbet, inget bygge behövs.
- Börja med en användare. Öppna läs-vyer för kollegor när flödet är stabilt. Spara automationen till sist.
Verktygen jag använder
Andra generationen vilar på ett skrivbordsprogram med läs- och skrivförmåga mot en mapp: Claude Desktop eller Claude Cowork. Mappen synkas via OneDrive/SharePoint, som också ger backup och spårbarhet. Inuti mappen är CLAUDE.md navet: projektets gemensamma minne, det första harnessen läser vid varje sessionsstart. Återkommande arbetsmoment fångas som skills, markdown-instruktioner som lär AI:n domänens egna rutiner.
Ordningen är svårare än tekniken. En välstrukturerad mapp med en ärlig CLAUDE.md slår en större modell mot en rörig hög filer, varje gång.
Källor och vidare läsning
Se källorna i artikelns metadata för originalreferenser.
Källor
Relaterade artiklar
- horisontellt-vertikalt-ai-stod — Den här artikeln zoomar in på det horisontella (generella) spåret och dess utveckling över tid
- harness-design-principer — Harnessen är motorn i andra generationen, lagret som läser mappen och bygger kontext
- agentminne-blir-infrastruktur — Det växande arkivet är projektminne som infrastruktur, något att läsa och granska