Horisontellt eller vertikalt — två sätt att ge ett företag AI-stöd
Det ena lindar en generell agent-yta runt företagets egna filer: bred täckning, ingen app byggs. Det andra bygger en skräddarsydd agent för en enda domän: smal, djup, mätbar. Mellan dem ligger ett spektrum, och valet av rätt leveransform avgör mer än valet av modell.
Nyckelinsikter
- Horisontellt AI-stöd lindar en generell agent-yta (Claude Cowork) runt företagets egna filer. Värdet ligger i strukturen man lägger runt (mappar, en CLAUDE.md, skills, kopplingar till källsystem), inte i en byggd applikation. En assistent, många uppgifter.
- Vertikalt AI-stöd bygger en skräddarsydd agent för en enda domän: eget gränssnitt, eget register, eval-sviter, kopplingar mot affärssystem. Koden är 10–15 % av arbetet; domäninternaliseringen (35–45 %) och eval-sviterna är det som tar tid och blir vallgraven.
- Mellan brett och djupt ligger ett spektrum, inte ett binärt val: live artifact → hybrid → enkel skill → agent med register → tvärsystemsagent → greenfield. Rätt leveransform är en bedömning, inte ett förvalt 'bygg en agent'.
- Live artifacts är bryggan mellan riktningarna: deterministiska appar som lever inuti Cowork-chatten, talar med MCP-servrar och kostar noll tokens vid drift. App-lik precision levererad genom den breda ytan.
- Valet styrs av bredd kontra djup och av mognad: ge först den generella ytan struktur (projektminne) innan något skräddarsytt byggs. Hoppa inte direkt till toppen av trappan.
Sammanfattning
Det finns två sätt att sätta AI i arbete i en verksamhet, och de drar åt olika håll. Det ena är brett: man tar en generell agent-yta (Claude Cowork) och lindar den runt företagets egna filer. Ingen applikation byggs. Värdet kommer av strukturen man lägger runt ytan: mappar som speglar verksamheten, en konstitution i en CLAUDE.md, en beslutslogg som växer, ett bibliotek av skills, kopplingar till källsystemen. En assistent som når hela ytan och hjälper till med många olika uppgifter. Jag kallar det horisontellt AI-stöd.
Det andra är djupt: man bygger en skräddarsydd agent för en enda domän: eget gränssnitt, eget dataregister, eval-sviter som mäter kvaliteten, kopplingar mot de affärskritiska systemen. Smalt uppdrag, hög precision, kvalitet som går att mäta. Det är vertikalt AI-stöd.
Riktningarna ställs ofta upp som ett val mellan två lådor. I praktiken ligger de i var sin ände av ett spektrum, med flera leveransformer däremellan, och med en brygga, live artifacts, som lånar det bästa från båda. Den här artikeln går igenom bredden, djupet, spektrumet mellan dem, och hur valet faller ut.
Två riktningar
Bredd och djup är två olika frågor man ställer till samma teknik.
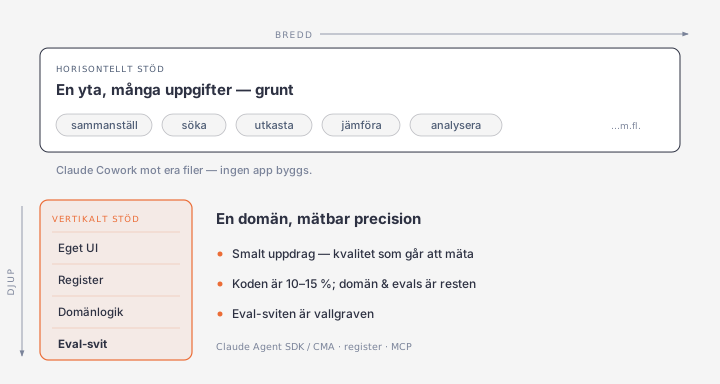
Den horisontella frågan är: hur många av våra uppgifter kan en och samma assistent hjälpa till med, om den får tillgång till våra filer och vår struktur? Svaret blir en generell yta som täcker mycket grunt: den läser dokument, sammanställer, utkastar, söker, jämför, över hela verksamhetens bredd. Den är aldrig expert på någonting, men den är inom räckhåll för allting.
Den vertikala frågan är: hur bra kan en agent bli på en enda sak, om vi bygger allt runt just den uppgiften? Svaret blir en smal lösning som går djupt: den kan en domän, har ett gränssnitt format efter arbetsflödet, ett register som speglar verkligheten, och en mätbar kvalitetsnivå. Den gör en sak, och den gör den så väl att man vågar luta sig mot resultatet.
En vass generalist-assistent som når varje låda i arkivet, mot en specialbyggd maskin för en enda arbetsuppgift. Båda är AI-stöd. De löser olika problem.
Det horisontella stödet
Det horisontella stödet bygger ingen app. Det tar en agent-yta som redan finns och ger den något att arbeta mot.
Ytan i sig, Claude Cowork, är en harness: lagret som omvandlar en kort fråga till tjugotusen tokens kontext genom att själv leta upp rätt filer, läsa dem och hålla ordning på arbetet. Den förmågan finns färdig. Det man tillför är råmaterialet och ramarna runt det:
- En mappstruktur som speglar verksamheten. Ordningen följer hur arbetet faktiskt rör sig, inte tematiska högar.
- En CLAUDE.md som projektets konstitution. En text som beskriver vad det här är, vilka begrepp som gäller, hur saker ska göras. Den växer med projektet.
- En beslutslogg. Varje vägval dokumenterat, så att ytan vet inte bara vad som finns utan varför.
- Ett bibliotek av skills. Markdown-instruktioner som lär ytan domänens egna arbetsmoment: hur en viss sorts dokument analyseras, hur en risk extraheras, hur en agenda byggs.
- Kopplingar via MCP till de system där data redan bor.
Resultatet är en assistent som det går att prata med. Lägg en ny fil i mappen, och den kan genast sammanfatta den, väva in den i en analys, jämföra den mot det som redan finns. En beställare uttryckte det som att man inte köper en applikation utan sätter upp en infrastruktur: så fort information landar i mappen kan man fråga den om saker och få tillbaka presentationer, analyser och uppdateringar.
Ett konkret läge där det här passar: ett samägt bolag bakom en stor markexploatering (miljontals kvadratmeter mark som ska planläggas, utvecklas, byggas och säljas) med ett konsultteam på ett par dussin personer som producerar planhandlingar på hundratals sidor inom vatten, geoteknik, miljö och trafik. Att mata in samma handlingar i en chatt om och om igen, utan minne mellan gångerna, ger ett grunt stöd som glömmer allt när fönstret stängs. Att i stället lägga handlingarna i en delad, strukturerad mapp som en Cowork-yta läser autonomt ger ett projektminne som fördjupas för varje session. Frågan "var var vi nu igen?" byts mot ett svar på några sekunder. Ingen rad applikationskod skrevs. Språnget från chattfönstret man matar för hand till en yta som läser mappen själv är skiljelinjen mellan första och andra generationens generella AI-stöd.
Tröskeln är låg, täckningen bred, och samma uppställning bär många olika uppgifter. Priset är att stödet stannar på generell nivå. Det blir aldrig en mätbar specialist.
Det vertikala stödet
Det vertikala stödet vänder på prioriteringen. Här är uppgiften smal och kravet på kvalitet högt nog att en generell yta inte räcker.
Då bygger man en agent: ett eget gränssnitt format efter arbetsflödet, ett register som modellerar domänen, kopplingar mot affärssystemen via MCP, och eval-sviter som mäter om agenten gör rätt. Tekniskt vilar det på Anthropics ekosystem: agentloopen körs via Claude Agent SDK eller Claude Managed Agents (CMA), med register-CRUD och domänlogik runt omkring.
Koden är 10–15 % av arbetet. Tyngdpunkten ligger någon annanstans:
- Domäninternalisering, 35–45 %. Att förvandla domänexperternas tysta kunskap till något agenten kan agera på. Det här är den största posten, och den går inte att kopiera. Att byta leverantör betyder att bygga om den delen från noll.
- Eval-författande, 20–30 %. Att definiera vad rätt svar är, i tillräckligt många fall, så att kvaliteten går att mäta i stället för att gissas. Eval-sviten är det som gör agenten driftsäker, och vallgraven som skiljer den från en demo.
- Datamodellering, implementation och förankring. Resten.
Exempel på vertikala leveranser: en agent för teknisk försäljning av en industriprodukt, en agent för en specialiserad produktdomän som industriella värmekablar, en agent som granskar fakturor mot flera olika system samtidigt. Var och en lever i sin egen domän, med sitt eget gränssnitt och sina egna mätpunkter. Den breda Cowork-ytan kommer aldrig dit, och behöver inte heller, för det är inte dess jobb.
Smalt, djupt och mätbart, men också dyrare, långsammare och mer låst till en enda uppgift än det horisontella stödet. Det är priset för precisionen.
Spektrumet mellan dem
Mellan den breda ytan och den skräddarsydda agenten ligger en trappa av leveransformer. Att se den gör att man slutar fråga "ska vi bygga en agent?" och börjar fråga "vilken form löser det här billigast, snabbast och säkrast?"
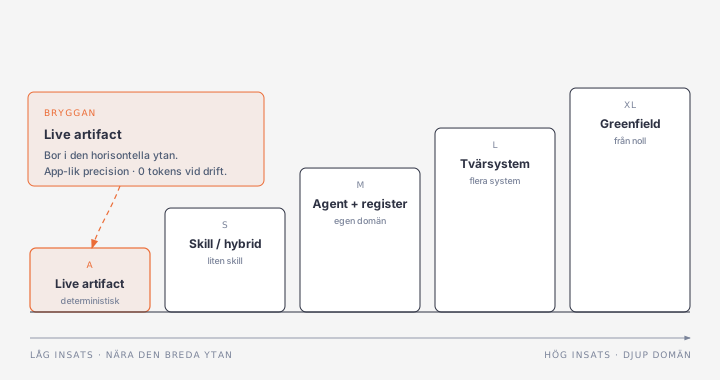
Trapporna, från lägst till högst insats:
| Form | Vad det är | Insats |
|---|---|---|
| Live artifact | Deterministisk app mot befintlig MCP-källa | Lägst: UX väger tyngre än domänarbete |
| Enkel skill / hybrid | Liten skill ovanpå Cowork, eller artifact med en sammanfattningsknapp | Låg |
| Vertikal agent med register | Agent med eget dataregister och MCP-verktyg | Medel: eval-arbete tillkommer |
| Tvärsystemsagent | Agent som arbetar över flera system | Hög: evals över flera källor |
| Greenfield | Komplex domän, evals byggda från noll | Högst: kalibreras efter en inledande utredning |
Insikten bakom trappan är att ett behov som låter som "vi behöver en AI-agent" ofta är ett deterministiskt fall som löses bättre längre ner. Att rekommendera den billigare formen när den räcker bygger förtroende, och sparar beställaren från en agentbudget där en sida hade gjort jobbet.
Live artifacts — bryggan
En live artifact sitter på trappans nedersta steg och förtjänar en egen förklaring, för den lånar från båda riktningarna.
Det är en självständig webbapp i ren HTML, CSS och JavaScript, som renderas inuti Cowork-chatten och har direkt access till kundens MCP-servrar via ett injicerat API:
await window.cowork.callMcpTool("mcp__<server-id>__<verktygsnamn>", { params })
Anropet översätts till MCP-protokollet över sessionens auktoriserade kontext, med autentiseringen hanterad automatiskt. En sådan tracker eller dashboard är arkitektoniskt närmare en vanlig webbapp än en agent: tokens spenderas när artifacten byggs i Cowork, men en omladdning kostar noll tokens oavsett hur mycket data den hämtar. Den är deterministisk: den resonerar inte, den visar.
En live artifact ger app-lik precision och förutsägbarhet, men distribueras genom den horisontella ytan och byggs i AI-flödet. Den breda ytan och den djupa precisionen möts i samma objekt.
Hur man väljer
Två frågor avgör riktningen, och en tredje avgör takten.
Bredd eller djup? Om behovet är många olika uppgifter med rimlig kvalitet pekar det mot horisontellt. Om behovet är en uppgift med kvalitet hög nog att luta sig emot pekar det mot vertikalt. Mätbarhet är vattendelaren: i det ögonblick någon vill kunna säga "agenten har rätt i 95 % av fallen" behövs eval-sviter, och då är man på den vertikala sidan.
Vilken leveransform på trappan? Börja längst ner och klättra bara så högt som behovet kräver. En deterministisk uppgift stannar på live artifact. En domän med tyst expertkunskap och krav på mätbar kvalitet motiverar en agent.
Och i vilken takt? Här finns en mognadstrappa som är lätt att hoppa över. Den lägsta nivån är chatt med manuella uppladdningar. Nästa är en harness mot lokala filer: en strukturerad mapp med CLAUDE.md, leveranser och skills. Högst upp ligger team-flöde med automation: flera användare, schemalagda körningar, notifieringar, spårbarhet. Varje nivå bygger struktur som nästa lutar sig mot. Projektminnet på den mellersta nivån är det automationen på toppen hänger sin spårbarhet och sina triggers i. Utan det har toppen ingenting att fästa i. Den som hoppar direkt till toppen bygger på lös sand.
Ordningen i praktiken: ge först den generella ytan struktur, låt projektminnet växa, och bygg skräddarsytt först där bredden tar slut och en mätbar specialist behövs.
Verktygen jag använder
Den horisontella ytan är Claude Cowork, en färdig harness som läser en mapp och bygger kontext själv. Det jag tillför där är struktur (mappordning, CLAUDE.md, beslutslogg), skills i markdown, och MCP-connectors mot de system där data bor. MCP är den gemensamma standarden i båda riktningarna: samma protokoll kopplar både den breda ytan och den djupa agenten mot källsystemen.
För live artifacts är window.cowork.callMcpTool-bryggan det som gör skillnaden. Den låter en ren webbapp inuti chatten tala MCP utan backend och utan tokens vid drift.
Den vertikala sidan vilar på Claude Agent SDK och Claude Managed Agents (CMA) för själva agentloopen, med register-CRUD och domänlogik runt omkring. Och genomgående, på den vertikala sidan, eval-sviter: utan dem är en agent en demo, inte en driftsäker leverans.
Efter att ha levererat åt båda hållen ser jag att modellvalet avgör mindre än man tror. Det som avgör är hur väl ytan är försedd med struktur i det horisontella fallet, och hur väl domänen är internaliserad och mätt i det vertikala.
Källor och vidare läsning
Se källorna i artikelns metadata för originalreferenser.
Källor
Relaterade artiklar
- forsta-andra-generationens-ai-stod — Det horisontella stödet har utvecklats i generationer, från chattfönstret man matar för hand till en yta som läser mappen själv
- harness-design-principer — Den horisontella ytan är harnessen, lagret som bygger kontext från en mapp med filer
- ai-agenternas-byggmaterial — Båda riktningarna sätts ihop av samma byggmaterial; skillnaden ligger i hur mycket man bygger själv
- kalla-inte-destination — Den ackumulerade datan och domänkunskapen är det agenten bygger ovanpå, samma princip oavsett riktning