Namnskyltar för agenten — bygg en app som en AI faktiskt kan testa
Jag lät fyra browser-automationsverktyg köra samma uppgift blint mot samma app. Alla klarade den. Skillnaden i antal anrop och fel avgjordes av hur appens markup var skriven, inte av verktyget.
Nyckelinsikter
- Fyra browser-automationsverktyg körde samma uppgift blint mot samma app och alla lyckades. Skillnaden i antal anrop och fel avgjordes av appens markup, inte av verktyget.
- Ett accessible name (aria-label eller roll+text) är den enda hook alla verktyg kan träffa. data-testid hjälper bara verktyg med en testid- eller CSS-selektor, som Playwright eller CSS-baserade agenter. Skriv markupen accessible-name-first och lägg testid ovanpå.
- När appen instrumenterades gick det koordinatbaserade verktyget från elva skärmbilder till noll: det slutade gissa pixelpositioner och läste elementens namn istället.
- Instrumentera även läs- och assert-mål som statustexter och headervärden, inte bara knappar. Annars faller varje testverktyg tillbaka på att skrapa fritext för att verifiera resultatet.
- En anpassad dropdown byggd på Radix/shadcn fällde alla fyra verktygen tills både triggern och varje alternativ fått en egen hook; att sätta den dolda native-selecten under den misslyckas tyst.
Sammanfattning
Jag bygger med AI-assisterad utveckling: Claude Code skriver koden och ska helst kontrollera sitt eget arbete direkt (köra appen, klicka igenom ändringen, se att den funkar) innan den går vidare. Ju snabbare den loopen sluts, desto bättre flow, desto snabbare rör sig utvecklingen, och desto färre tokens går åt. Samma budget räcker längre. Browserautomation är hur agenten stänger den loopen, så jag ville veta vad som faktiskt gör den snabb.
Jag lät fyra olika verktyg för browser-automation köra exakt samma uppgift, blint, mot en app jag byggt: öppna en kund, lägg upp en kontaktperson, öppna kundens offert, koppla kontakten på offerten. Varje verktyg fick sin egen färska körning utan att veta vad de andra gjort, och rapporterade tillbaka varje anrop det gjorde.
Alla fyra klarade uppgiften. Ingen av dem tog fel på slutresultatet. Det som skilde dem åt var hur mycket jobb de behövde för att komma dit: antal anrop, antal skärmbilder, antal misslyckanden på vägen. Samma verktyg blev billigt eller dyrt beroende på en sak: hur appens markup var skriven.
Efter första omgången instrumenterade jag appen med samma aria-label och stabila hook-attribut som gör en app användbar med skärmläsare. Sedan körde jag om alltihop. Det koordinatbaserade verktyget, som tidigare tog elva skärmbilder för att hitta var knapparna satt, tog nu noll. Samma arbete som gör appen tillgänglig gjorde den billig för en AI att driva.
Experimentet: fyra sätt att hitta rätt dörr
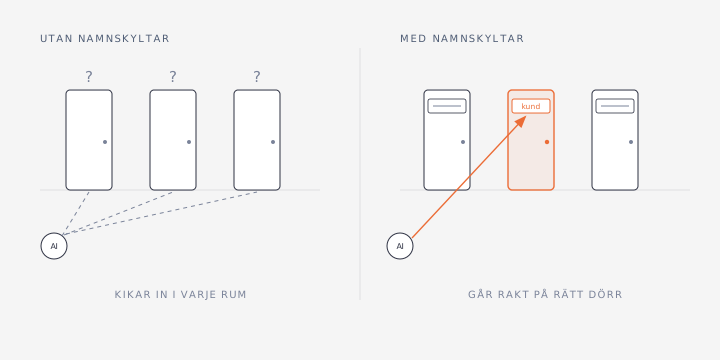
En agent som ska styra en webbläsare står inför samma problem som en människa som letar rätt rum i en stor byggnad: den måste veta vilken dörr som är rätt. De fyra verktygen löser det på fyra olika sätt.
- Claude-in-Chrome tar en skärmbild, resonerar om var elementen sitter i pixlar, och klickar på koordinater. Den läser byggnaden genom att titta.
- Safari MCP (Apples nya MCP-server, inbyggd i Safari Technology Preview) läser upp ett textträd av sidan och agerar på semantiska referenser i det.
- Claude Desktops inbyggda preview riktar sig mot element med CSS-selektorer.
- agent-browser (ett CLI från Vercel Labs) tar en "snapshot" som ger varje element en stabil referens, plus semantiska sökare för roll, namn och testid.
De skiljer sig också i något djupare än hur de hittar dörren: hur de öppnar den. Safari och agent-browser griper tag i själva handtaget: de skickar klicket till elementet i sidan. Chrome och Claude-appens inbyggda browser siktar i stället på var handtaget ser ut att sitta på ett foto av sidan, och trycker där.
Ett foto har en kant. Dörrar utanför bilden finns inte för den som bara har fotot, och ber man om en förteckning över dörrarna får man tyst bara de som råkar synas. Att sikta på en koordinat är därför bundet till vad som är i vy just nu; att sikta på ett handtag är det inte. Den skillnaden, inte hur snyggt verktyget läser sidan, avgjorde mest hur ofta de missade.
Uppgiften var densamma för alla: fyra steg i en intern offert- och kundhanteringsapp skriven i React och TanStack. Varje verktyg drevs av en egen subagent med en hård regel: använd bara den här verktygsuppsättningen, och logga varje anrop. Ingen av agenterna hade tillgång till mitt facit, så ingen kunde härma en tidigare körning.
Vad hände utan namnskyltar
I första omgången var appen skriven som de flesta appar är: knappar och rader kändes igen på sin synliga text, inget mer.
Två saker snubblade alla fyra. En anpassad dropdown för att välja kontaktperson gick inte att styra på det uppenbara sättet: flera verktyg fick tillbaka "lyckades" medan offerten i själva verket sparades utan kontakt. Och headern som skulle bekräfta resultatet var omärkt text, så varje verktyg fick skrapa sidan för att se om kopplingen gått igenom.
Claude-in-Chrome betalade dyrast. Eftersom den klickar på koordinater måste den se sidan först — elva skärmbilder gick åt bara till att lokalisera var knapparna satt, och varje klick gav inget tillbaka om sidans nya tillstånd, så nästa kontroll krävde ännu en bild.
Vad hände med namnskyltar
Sedan instrumenterade jag appen. Två sorters hook på varje interaktivt element: ett unikt aria-label ("Contact actions — {kundnamn}") och ett data-testid byggt från elementets namn via en slugify()-funktion (contact-option-anna-andersson, inte ett UUID). Både trigger och varje alternativ i dropdownen fick sin egen hook. Ingen ändring i hur appen fungerar, bara i hur den kan pekas ut.
Skillnaden syntes tydligast hos det verktyg som verkade minst släkt med markup:
| Verktyg | Utan namnskyltar | Med namnskyltar |
|---|---|---|
| Claude-in-Chrome | 11 skärmbilder | 0 skärmbilder |
När Chrome fick namn att gå på lutade den sig på aria-label via sidans accessibility-träd och slutade helt att ögonmäta pixlar. Den bytte från att titta på byggnaden till att läsa namnskyltarna på dörrarna.
agent-browser berättade en annan historia, om att läsa manualen. Min första körning gjorde jag genom att peta råa kommandon utan att läsa verktygets egen core-skill, den som uttryckligen säger "läs mig först". Den körningen tog 34 anrop och gick i tre fällor, bland annat den dolda selecten. När jag körde om med en agent som läste core först föll det till 25 anrop och noll fel. Skillen varnar för både den dolda selecten och för att referenser blir inaktuella efter varje sidändring. Och med appens exakta hookar utpekade: 20 anrop. Två av de tre "felen" i första körningen var alltså inte appens eller verktygets brister, utan att jag inte läst instruktionen.
Varje skärmbild och varje extra anrop är tid och tokens i loopen där agenten kontrollerar sitt eget arbete. Färre av dem håller flowet uppe, snabbar på utvecklingen och gör tokenbudgeten dryare. Det var därför jag mätte det här från början.
Namnskylt eller tjänste-nyckel
När jag ledde varje verktyg mot de nya hookarna framträdde en skillnad som avgör vad man faktiskt ska satsa på.
data-testid gick bara att träffa direkt med verktyg som har en testid- eller CSS-selektor: Claude Desktops preview ([data-testid="…"]) och agent-browser (find testid …). För dem blev dropdownen som fällt alla ett enda klick, och preview kunde skriva selektorerna i förväg utan en enda utforskande snapshot.
Chrome och Safari har ingen sådan selektor. De kom åt hookarna ändå, men via aria-label och elementens namn i stället för testid. När jag försökte tvinga Safari mot testid blev det till och med långsammare: den fick köra JavaScript-omvägar för varje testid-element, och hamnade på fler anrop än när den fick gå på text som vanligt.
Ett data-testid är en tjänste-nyckel: praktisk, men bara för de besökare som bär på rätt sorts nyckel. Ett accessible name är namnskylten på dörren: den fungerar för alla, inklusive skärmläsaren för en människa som inte ser skärmen. Investeringen som gynnar flest verktyg, och flest människor, är namnskyltarna.
Verktygen jag använde
Browserstyrning är en av förmågorna en agents harness kopplar in. Fyra verktyg, fyra profiler:
- Claude-in-Chrome. Koordinat- och synbaserat. Fungerar överallt, även på sidor utan bra markup, men betalar i skärmbilder. Blir klart bättre av instrumentering, men bara via accessible names.
- Safari MCP. Apples inbyggda server i Safari Technology Preview, byggd på
safaridriver. Läser sidan som ett textträd och returnerar en diff av vad som ändrades efter varje interaktion, vilket gör verifiering billig. Ingen förstklassig testid-selektor. Endast macOS. - Claude Desktops preview. Så såg Desktop-appens inbyggda browser ut vid testet: native CSS-selektorer som träffade
data-testiddirekt, plus nätverkspanel. Den har sedan ersatts av Claude Browser, som läser sidan semantiskt men klickar på pixel-nivå, så den CSS-direkta träffen gäller inte längre. - agent-browser. MCP-nativ Rust-CLI från Vercel Labs, med snapshot-och-referens-flöde, semantiska sökare, nätverksinspektion och en auth-vault. Levereras med skills: läs
coreinnan du kör, och använddogfoodför QA-svep.
Rekommendationen jag landade i: kör du Claude Code i terminalen (CLI), gör agent-browser till förstahandsval och ladda core-skillen först. Kör du i Desktop-appen duger den inbyggda Claude Browser gott, men den blir dyr när den ska leta sig fram i en app den inte känner, och dess sidförteckning räknar bara upp det som är i vy. Scrolla målet in i bild innan du jagar det, och ta agent-browser när det ska vara robust eller köras i CI.
En efterkontroll gjorde den poängen skarp. Samma uppgift, samma verktyg: när agenten först fick läsa appens egen testbarhets-konvention sjönk kostnaden från 50 anrop till 33: noll skärmbilder, noll JavaScript, inga koordinatklick. Det jag först läste som ett skört verktyg var i huvudsak priset för att leta i en okänd app.
I praktiken
Reglerna för testbarhet jag tar med mig till nästa app, oavsett vilket verktyg som ska driva den:
- Accessible-name-first. Riktiga
<button>,<label for>och roller, med unika namn per rad och åtgärd. Det är den hook som varje verktyg, och varje skärmläsare, kan träffa. Läggdata-testidovanpå som ett namn-slug-komplement för ditt E2E-ramverk. - Instrumentera även det du verifierar. Ett statusvärde eller en header som ett test läser av behöver en hook lika mycket som en knapp. Annars faller verktyget tillbaka på att skrapa fritext.
- Anpassade widgets drivs via den synliga kontrollen. En Radix- eller shadcn-select styrs via triggern och alternativen, inte den dolda inputen under. Ge både triggern och varje alternativ en egen hook.
- Namn-slugs kodar visningsnamnet. De bryts när något döps om och krockar vid dubbletter, så behåll ett stabilt id-attribut vid sidan om.
- Verifiera på persisterat tillstånd, inte på notisen. En toast hinner försvinna innan verktyget hunnit läsa den. Det som står kvar (headern, raden, API-svaret) är det pålitliga beviset.
Reglerna gör ingen nytta om agenten inte känner till dem. Jag kodar in dem i appens CLAUDE.md: en delad författnings-halva, plus en kort halva för hur verktyget ska ledas beroende på om jag kör Claude Code i Desktop-appen eller i terminalen:
## Testability & browser automation

### Authoring components
- Accessible-name-first: real <button>/<label for>/roles; unique names per row/action.
- Add data-testid as a name-slug supplement (slugify(name), not a UUID).
- Instrument read/assert targets (status/header values), not just click targets.
- Custom widgets (Radix/shadcn select): drive the visible trigger + option, never the
  hidden native input; put a testid on the trigger AND each option.
- Assert on persisted state (header/row/API), never on the transient toast.

### Driving the browser
# Desktop + Claude Browser → read_page, act on refs. read_page lists only what is
#   in view — scroll the target into view before hunting its ref.
# CLI + agent-browser → load the `core` skill first; prefer `find testid`;
#   re-snapshot after every DOM change.
Författnings-halvan är identisk oavsett spår, och den är den enda halva som också gör appen bättre för en människa med skärmläsare.
När jag tittade i agent-browsers dogfood-skill, den som gör QA-svep av en webbapp, fanns "omärkta formulärfält" och "saknade eller fel etiketter" med som rapporterbara buggar. Bristen som gör en app dyr att automatisera är samma brist som ett QA-svep flaggar, och samma brist som en skärmläsare snubblar på. Tre skäl att skriva namnskyltarna, en gång.
Källor och vidare läsning
Se källorna i artikelns metadata för originalreferenser.
Källor
Relaterade artiklar
- harness-design-principer — Browserautomation är ett av verktygen harnessen ger agenten; den här artikeln handlar om vad agenten kan greppa på andra sidan
- ai-agenternas-byggmaterial — Verktyg är agentens händer; testbar markup avgör vad de faktiskt får tag i